今天六个仓库里,Block、阿里、NVIDIA 各出了一个,方向都很实在:让 Agent 进团队群聊、给代码评审、把模型压小。另外两个小项目的星数涨得太快,我会提一句,但不下结论。
老规矩,每个说清它解决什么、适合谁、坑在哪。星数是 9 月 27 日上午在仓库页看到的,只是个大概。
1. block/buzz:人和 Agent 在同一个频道里干活
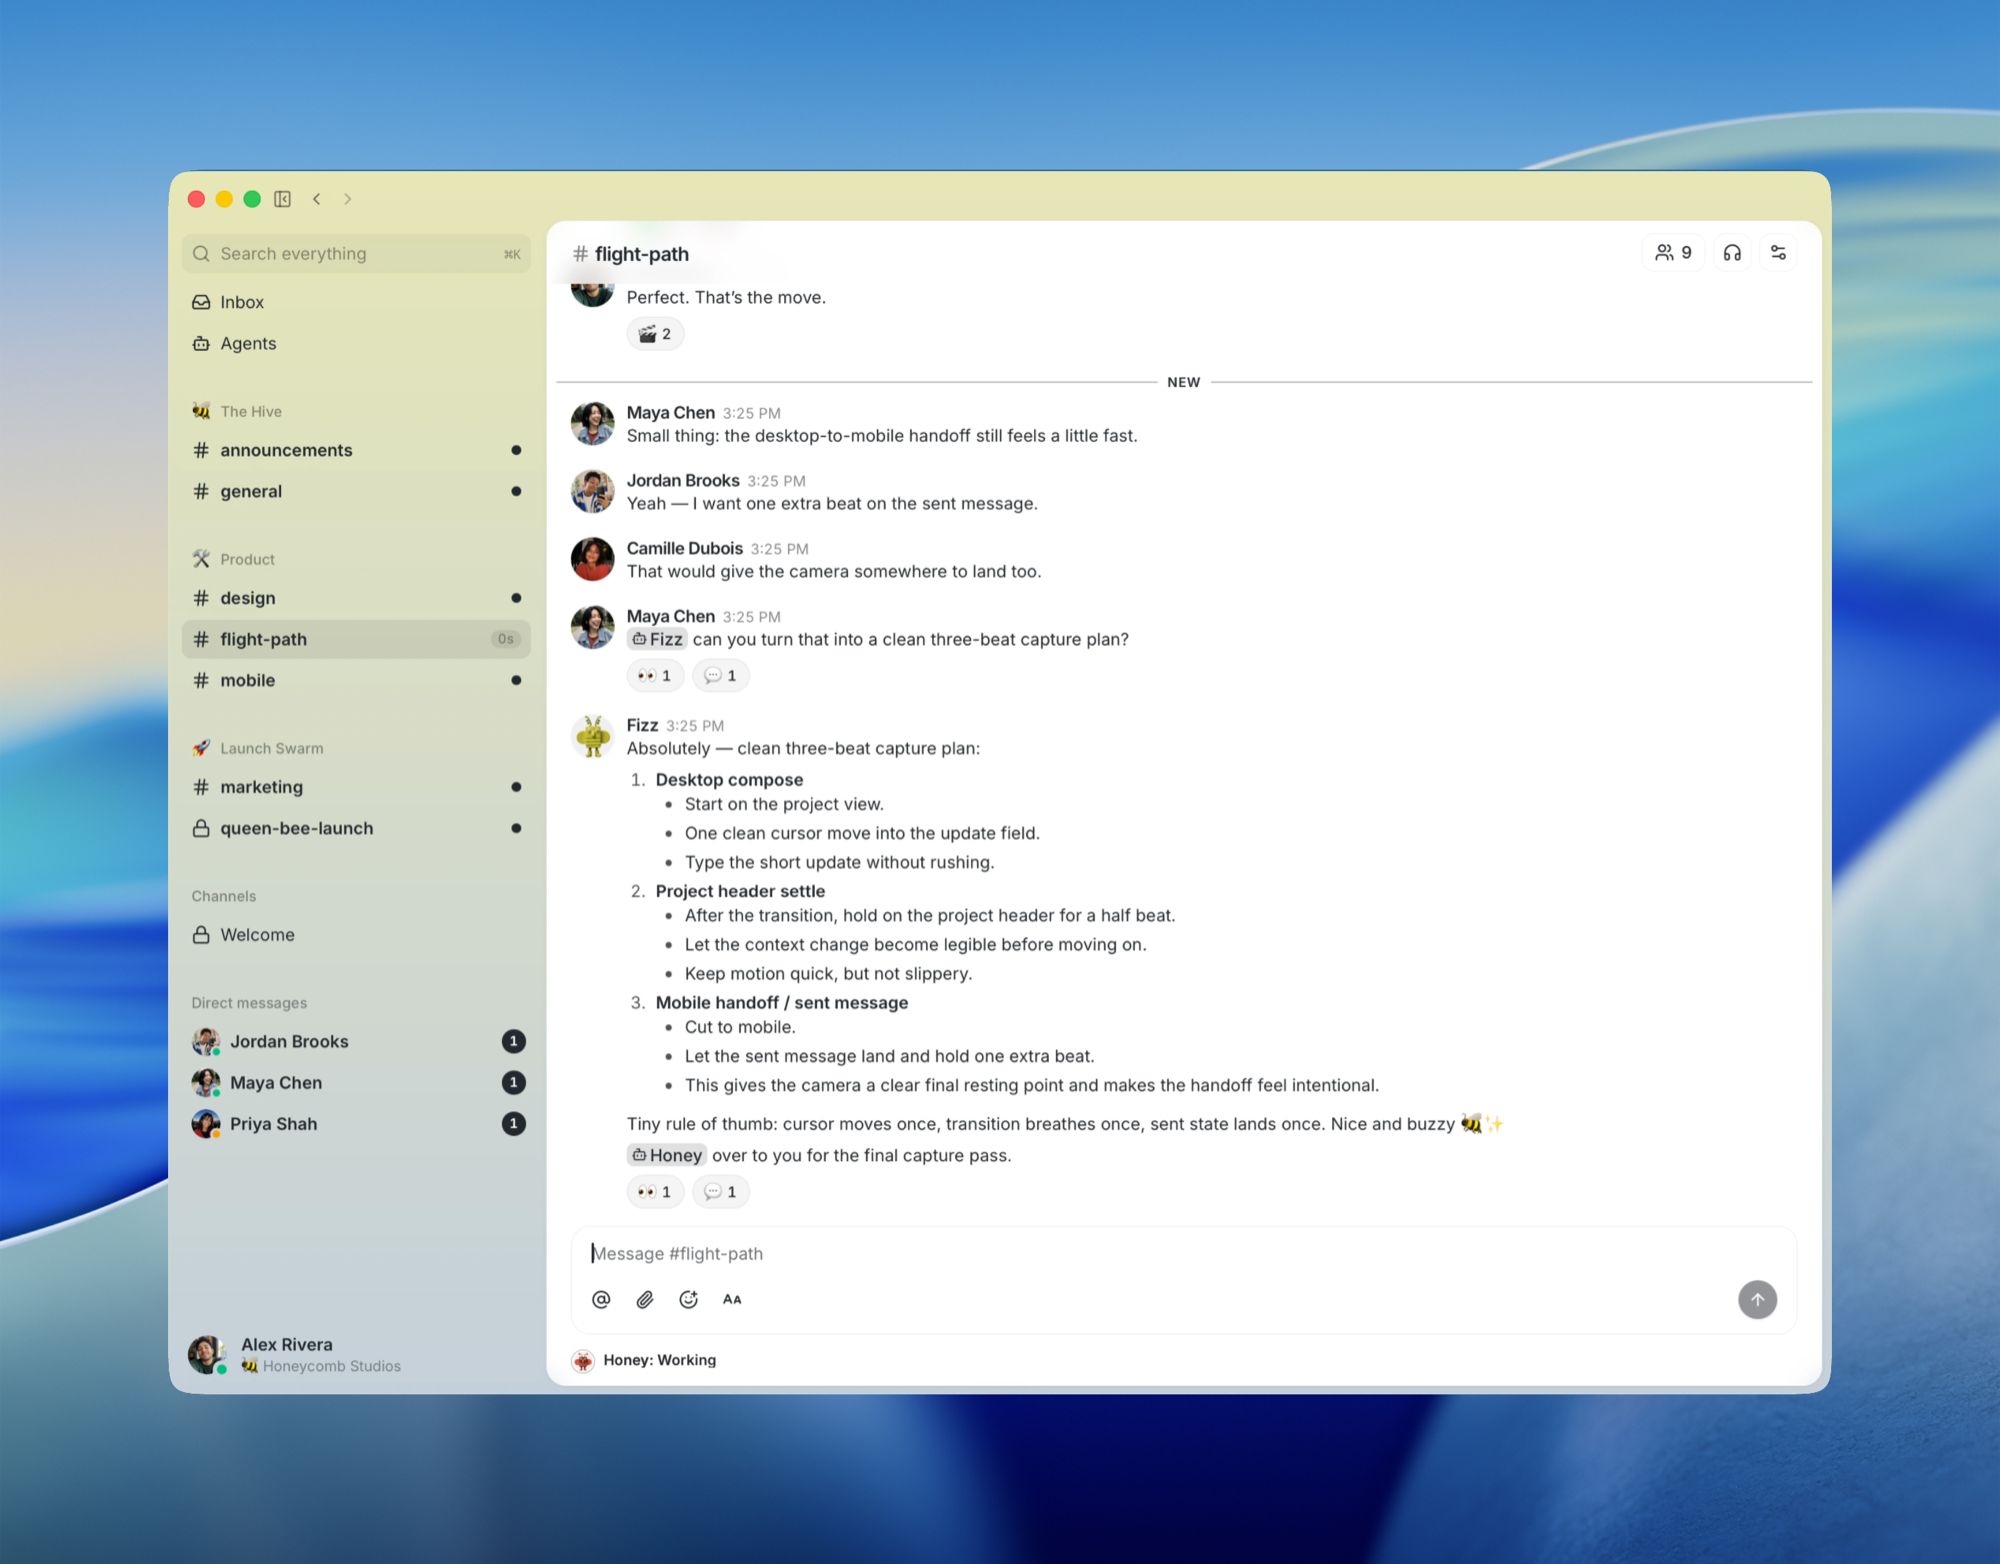
约 3.5 万星,Apache-2.0 协议,出自 Square 和 Cash App 的母公司 Block。它想做的是一个可以自己部署的团队工作区,人和 AI Agent 在同一个频道里聊天、提代码、跑工作流。每个 Agent 都有自己的密钥和身份,做过什么都有记录可查。
有一点要说清楚:它本身就是一个 Nostr 中继服务器,不只是借用了 Nostr 的思路,第三方 Nostr 客户端可以直接连上来。README 也特意写了它不是区块链。
适合想认真试试「Agent 当正式成员」的技术团队,尤其是在意数据留在自己手里的团队。想找一个现成 Slack 替代品的话,现在还早。
坑有两个。一是 README 自己写着还没完成,Windows 安装包也没签名。二是自己部署要同时跑 Postgres、Redis、对象存储和 git 存储,对小团队来说偏重。它还能给 Agent 开 shell 和改文件的权限,这类配置最好放在隔离环境里。
2. alibaba/open-code-review:阿里内部用过的 AI 代码评审

约 4.2 万星,Apache-2.0 协议。README 说它原本是阿里内部的代码评审助手,现在开源成了命令行工具。它读你的代码改动,给出精确到行的评论,可以接进 GitHub Actions、GitLab CI 这类流程。
清单里说它是「确定性规则加大模型」,我看完要纠正一下:确定的是流程,比如选哪些文件、给哪些文件套哪条规则、评论落在哪一行。规则本身是写给大模型的检查要点,比如「看看有没有 SQL 注入」,并不是静态扫描工具。
它的取舍我挺认可:README 承认召回率比直接用 Claude Code 低,换来的是误报少、token 花得少。支持的国内外模型很多,也能接本地模型。装起来是一条命令:
npm install -g @alibaba-group/open-code-review
要注意的是,用云端模型时你的代码改动会发给那家服务商,目前也没有脱敏功能。想代码不出内网,就得接自己部署的模型。它也替代不了人工评审。
3. mobile-next/mobile-mcp:让 Agent 操作真手机
约 7400 星,Apache-2.0 协议。它是一个 MCP 服务,让 Claude Code、Cursor、Codex 这类工具能操作 iOS 和 Android 的真机或模拟器。它优先读系统的无障碍信息来找按钮,读不到时才用截图加坐标点击,所以大多数时候不用视觉模型。
适合做移动端测试、想让 Agent 自动走一遍 App 流程的开发者。Android 那边要装 adb,iOS 基本要一台装了 Xcode 的 Mac。
这个工具给 Agent 的权限几乎等于整台手机:装卸 App、在任何 App 里输入和点击、读剪贴板和系统日志、改定位、录屏。请只在你自己的设备、或者明确授权你测试的设备上用,不要拿去操作别人的手机和账号。
还有两个坑。第一,匿名遥测默认开着,要手动关。第二,它可以开成网络服务,但不设密码时任何能连上的人都能控制设备,千万别这样暴露到局域网或公网。
4. NVIDIA/Model-Optimizer:把大模型压小、跑快
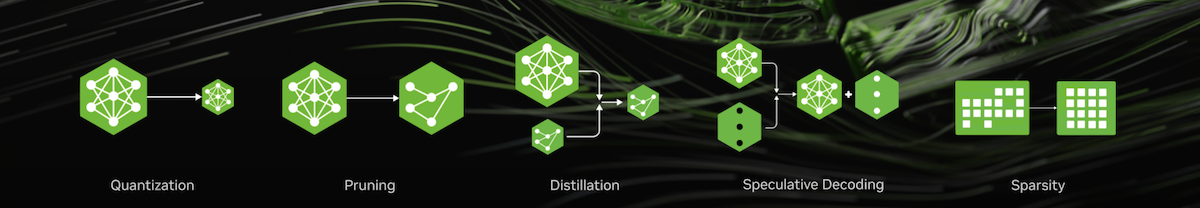
约 4800 星,Apache-2.0 协议。这是 NVIDIA 的模型压缩工具库,以前叫 TensorRT Model Optimizer。它把 Hugging Face 或 PyTorch 模型做量化、剪枝、蒸馏,还能训练投机解码用的小草稿模型,最后导出给 TensorRT-LLM、vLLM、SGLang 直接部署。目的就是省显存、提吞吐。
README 里有一些官方案例,比如某个模型剪枝加蒸馏加 FP8 之后吞吐提升 2.6 倍,这些是 NVIDIA 自己的数据。
适合在 NVIDIA 显卡上自己部署模型的推理工程师和 MLOps 团队。只用 Mac 或纯 CPU 跑模型的人用不上。
坑是它和 NVIDIA 生态绑得很紧,要 Linux 和 CUDA,NVFP4 这类新格式也要新一代显卡才有优势。它还没到 1.0,README 写明废弃的功能大约只留一个版本的迁移期,小版本升级也可能有破坏性改动,所以最好固定版本。
5. NandhaKishorM/laya:不生成文字、只做选择题的小模型
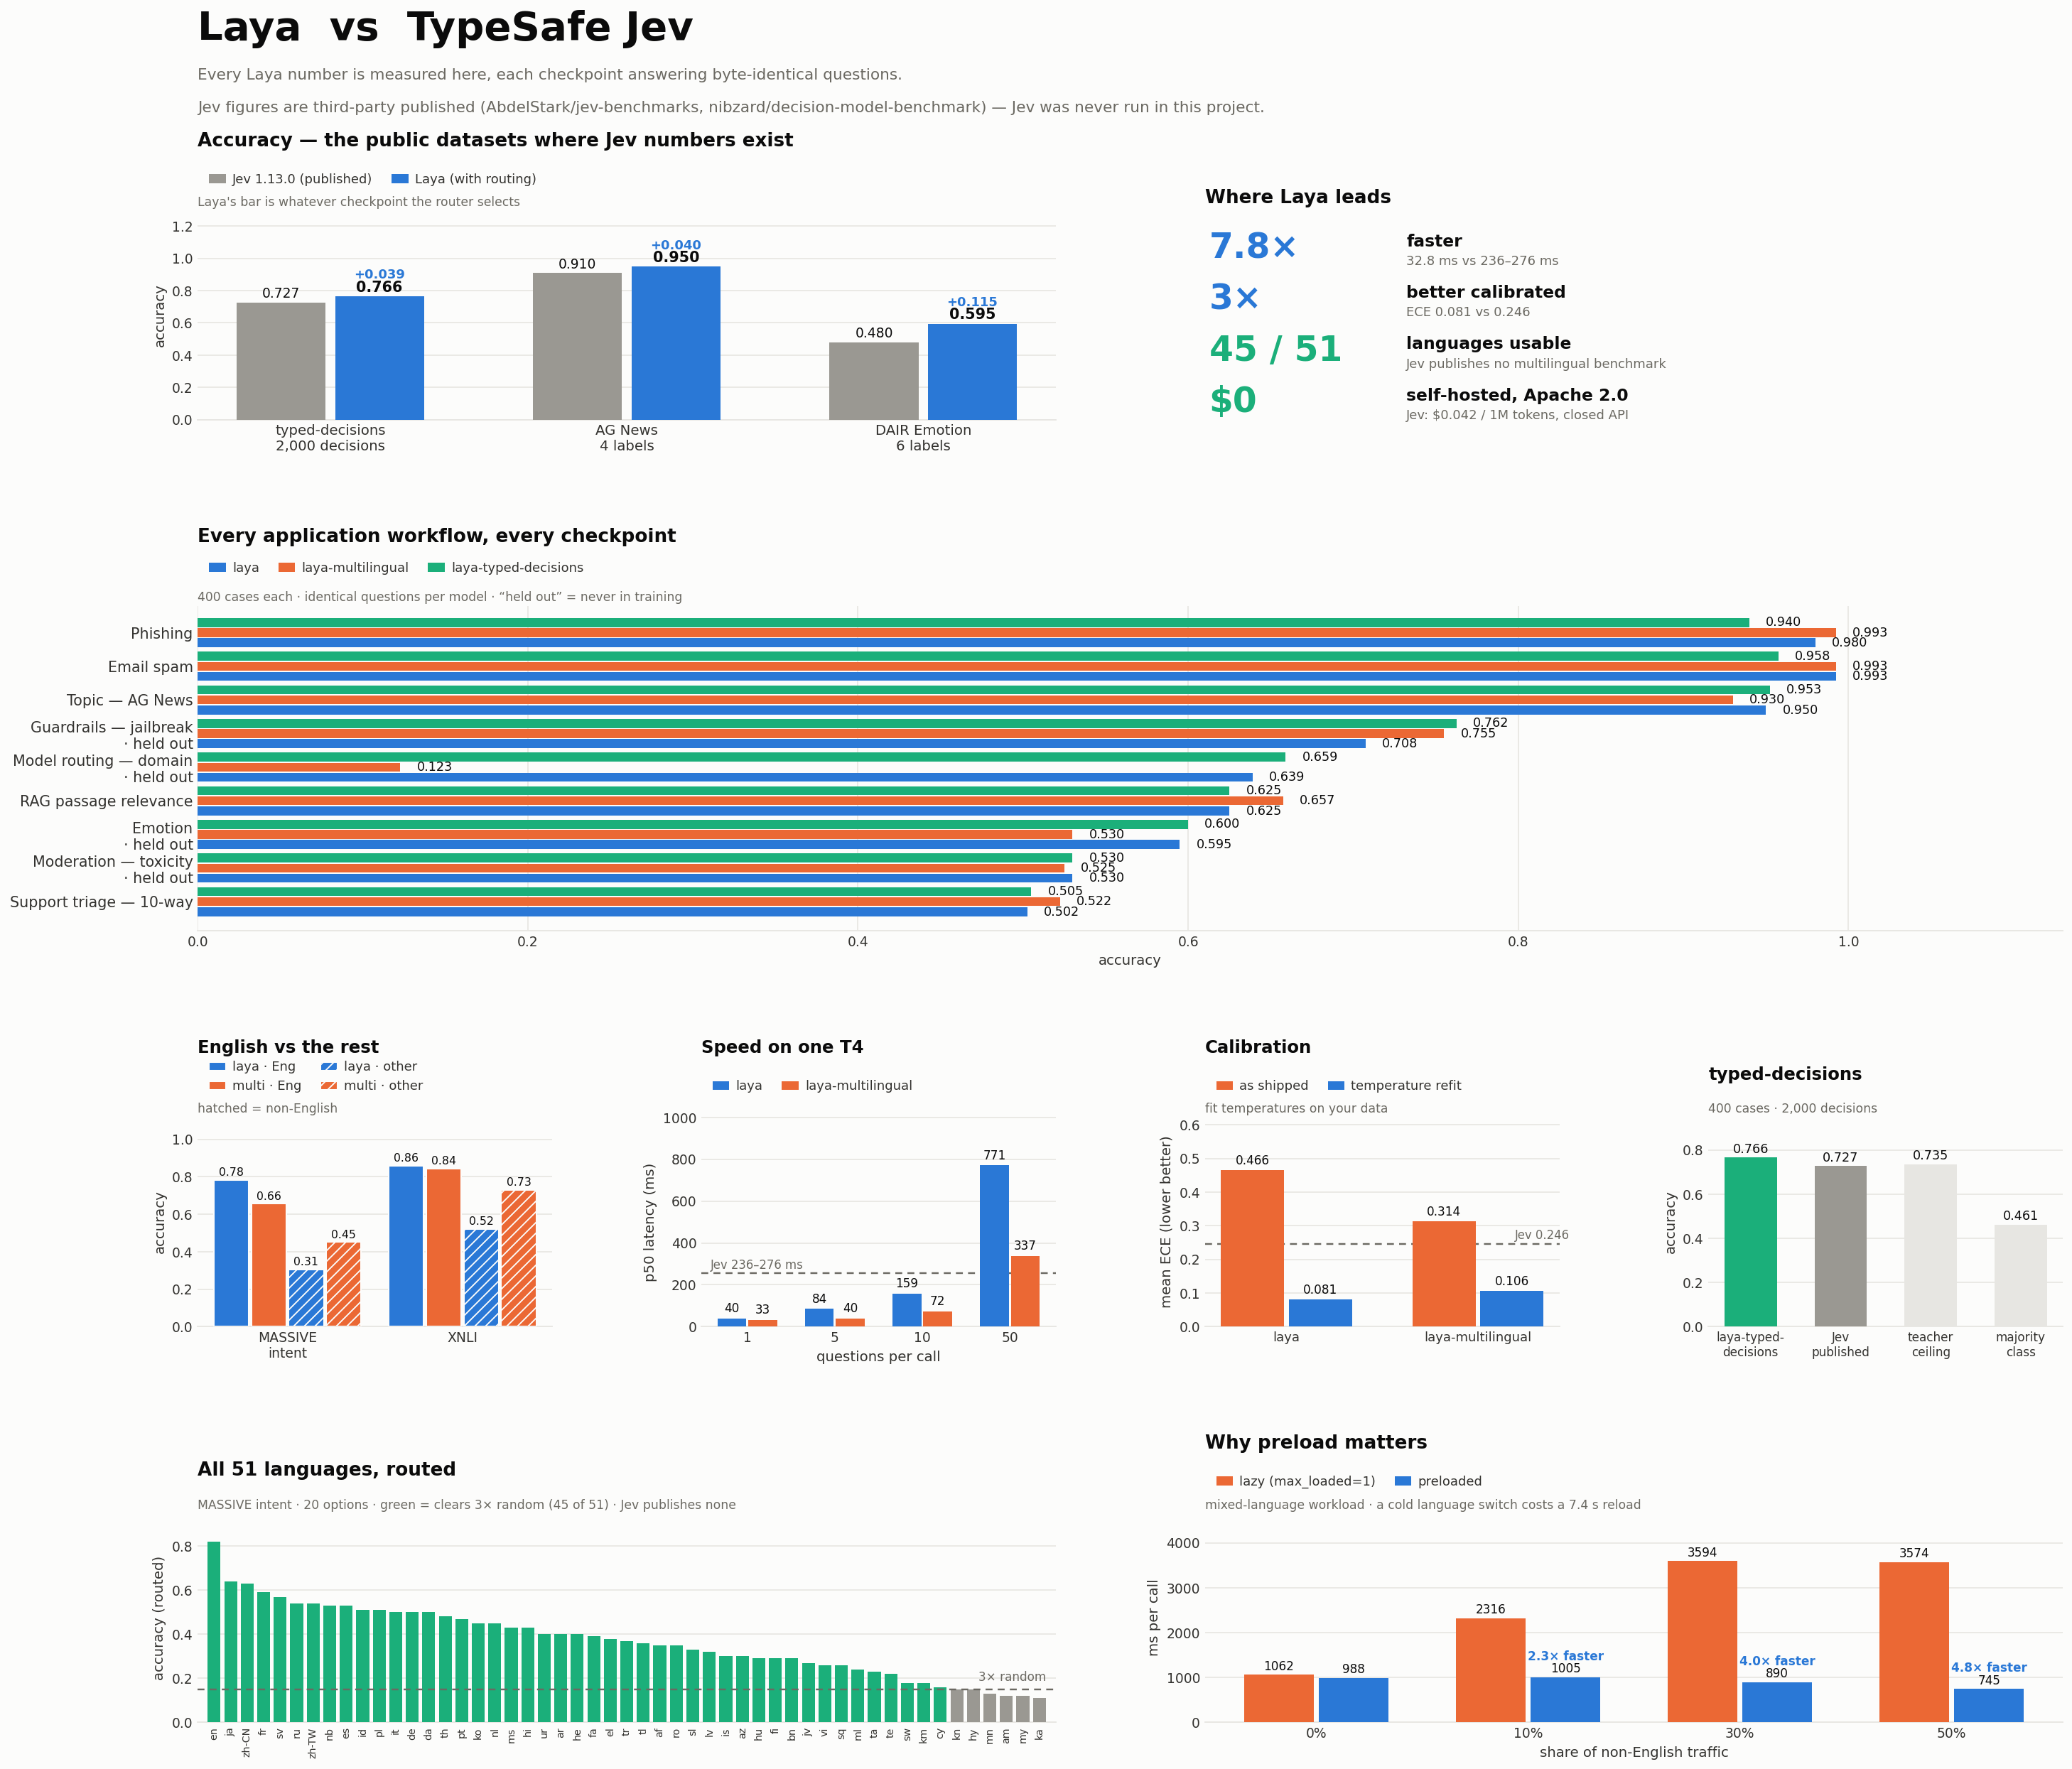
约 2.6 万星,代码和模型权重都是 Apache-2.0。它的思路挺有意思:不像大模型那样一个字一个字地生成,而是跑一遍就直接给出答案,只回答三类问题,也就是选哪个、打几分、是或否。README 称单题约 33 毫秒,适合工单分诊、意图路由、内容审核这类高频又简单的判断。
我欣赏它把局限写得很老实。基础模型不经过训练直接用,在作者自己的测试上接近瞎猜,必须拿自己的数据微调。选项超过 20 个左右准确率会大幅下降,否定句也容易判反,比如把「我不想取消」判成取消。
适合手里有标注数据、想把简单判断从大模型挪到便宜小模型上的团队。想直接拿来用的话,它不合适。
还有一点值得留意:仓库创建才 9 天就有约 2.6 万星,对一个小团队的模型来说涨得非常快。原因我没法核实,建议别把星数当质量信号。
6. hydra-db/hydradb:把图数据库放进 S3
约 8000 星。它是一个用 Rust 写的图数据库,数据全存在 S3 兼容的对象存储里,计算节点只做缓存,坏了可以直接换。能用 Neo4j 的驱动连接,查询语言是 Cypher。官网主打给 AI 做记忆和知识图谱,宣传成本低很多。
适合想用便宜的对象存储存大图、有 Rust 和 K8s 运维能力的团队,或者想研究这种存算分离架构的人。
坑比较多。第一,它只支持 Cypher 的一个子集,从 Neo4j 迁过来要改查询。第二,协议是 AGPL-3.0,改了代码又对外提供服务就要公开源码,商用前最好问问法务,背后的公司也在卖托管版。第三,项目很早期:版本还是 0.1,总共 37 次提交,五周多没更新,README 里链接的一致性测试报告我打开是空的。官方性能测试是在单机加本地对象存储上跑的,换成云上 S3 会慢不少。另外 37 次提交配 8000 星、3000 多 fork,这组数字也少见。