今天榜上最让我想点开的,是一个用纯 C 写的推理引擎 colibri。它的说法很大胆:几千亿参数的大模型,不用显卡,放在你手上这台电脑里就能跑。照 README 里贴出来的实测,确实能跑,只是你得先看清楚它有多慢。
另外五个也都有点意思:一个给大模型“改性格”的工具,一个免费的本地 AWS 模拟器,一个让你同时开好几个 AI 写代码的 Git 小工具,Cloudflare 开源的代码安全审计 Skill,还有一个专门帮你在闲鱼上蹲好货的监控系统。前 7 天写过的都跳过了。
1. JustVugg/colibri:几千亿参数的模型,塞进普通电脑
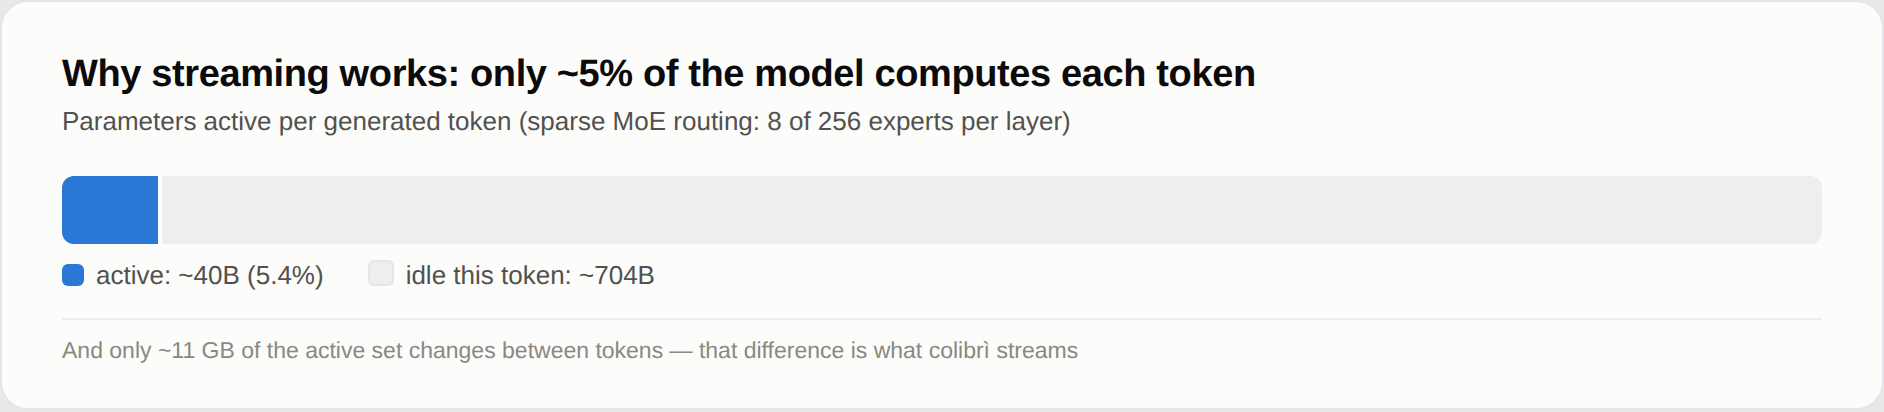
colibri 抓住的是混合专家模型(MoE)的一个特点:模型很大,但每生成一个词只用到一小部分。拿 GLM-5.2 来说,7440 亿参数,每个词大约只用 400 亿。于是它把常用的那部分留在内存里,其余的“专家”放在硬盘上,用到的时候再读。有显卡就把最热的专家放显卡上,没有也能跑。
所以 README 里 GLM-5.2 这一行写的是 16 到 24G 内存就能启动。但旁边的实测数字也写得很老实:25G 内存的笔记本冷启动,一秒只能出 0.05 到 0.1 个词;128G 内存的 Ryzen AI Max+ 机器一秒 1.83 个;六张 RTX 5090 才到 9 个左右。下载也要 429G 硬盘。
我的看法是,想日常用的话,先从它推荐的小模型开始,比如 Qwen3.6-35B,纯 CPU 一秒 6 个词左右。整个项目的最低门槛是 8G 内存和 22G 空余硬盘。大模型更适合“我就想亲眼看看它在我机器上转起来”的人,它的仪表盘会把每个专家被调用的过程实时画出来。
安装是一个脚本,它会先看你的内存、硬盘和显卡,再推荐一个装得下的模型,跑起来后还给出 OpenAI 和 Anthropic 兼容的接口地址,别的应用能直接接。Apache-2.0,4.7 万星,今天一天涨了 800 多。另外注意,引擎是 Apache-2.0,但每个模型保留自己的协议,比如 Qwen-Image-2.1 只能非商用。
2. p-e-w/heretic:不用训练,给开源模型改性格
Heretic 做的事以前只有大公司能做:不是运行模型,而是改模型。它不做昂贵的训练,用一组数学方法,根据对比提示词来调整模型的行为。默认动作是减少拒答,也就是常说的去审查。换个配置文件,还能让模型少点 AI 腔、少讲冷笑话、少拍马屁。
README 里有个实在的参考:RTX 3090 上处理一个 4B 的模型,默认配置大约 30 到 40 分钟。显存不够可以开 4 位量化,代价是精度会掉一点。社区已经用它做出了几千个模型传到 Hugging Face 上。
适合自己在本地跑开源模型、又被它动不动就拒绝或者满嘴套话烦到的人。老用户要注意,1.x 的配置文件和 2.x 不兼容,作者专门写了迁移指南。AGPL-3.0,3.9 万星,昨晚还有提交。
3. floci-io/floci:LocalStack 收紧之后的免费替代
做 AWS 开发的人大多用过 LocalStack,在本地模拟 S3、DynamoDB 这些服务,测试不花真钱。按 Floci 的 README,LocalStack 社区版今年 3 月起要认证令牌,安全更新也冻结了。Floci 就是冲着这个来的:不要账号,不要令牌,没有付费功能墙,MIT 协议,号称换个镜像就能平替。
覆盖面比我想的广。S3、SQS、Lambda、Cognito 都有,RDS、ECS、EKS 这类直接起真的 Docker 容器来跑,不是糊弄的假接口。README 里拿自己和 LocalStack 社区版比了一张表,启动时间、空闲内存、镜像大小都小一大截,这些是官方自己的数字。
适合在 CI 里跑 AWS 集成测试、或者不想给每个开发配云账号的团队。要用自带的网页控制台或者起容器类的服务,得把 Docker socket 挂进去。2.9 万星,今天上午还在提交,开着的 issue 有 170 个。
4. max-sixty/worktrunk:同时开五个 AI 写代码,不打架
现在用 Claude Code、Codex 的人,越来越多同时开好几个任务并行跑。为了不互相踩改动,最好每个 Agent 一个独立的工作目录,Git 自带的 worktree 就是干这个的,可惜很难用,开一个新的要把分支名敲三遍。
Worktrunk 把 worktree 变得和切分支一样简单:一个命令新建并直接启动 Claude,一个命令清理,一个命令看所有分支的状态。还能用 AI 写提交信息、一条命令合并收尾、给每个工作目录分配不同的开发端口。我最喜欢的是共享构建缓存,十个工作目录不用各装一遍依赖。
Mac 和 Linux 上一行就装好:
brew install worktrunk
两个限制 README 写了:共享构建缓存只支持 APFS、btrfs 和 XFS 文件系统;Windows 上 wt 这个命令会和 Windows Terminal 撞名,用 winget 装的话命令叫 git-wt。MIT 或 Apache-2.0 双协议,1 万星,今天早上刚提交。
5. cloudflare/security-audit-skill:Cloudflare 自己用来挖漏洞的那套流程
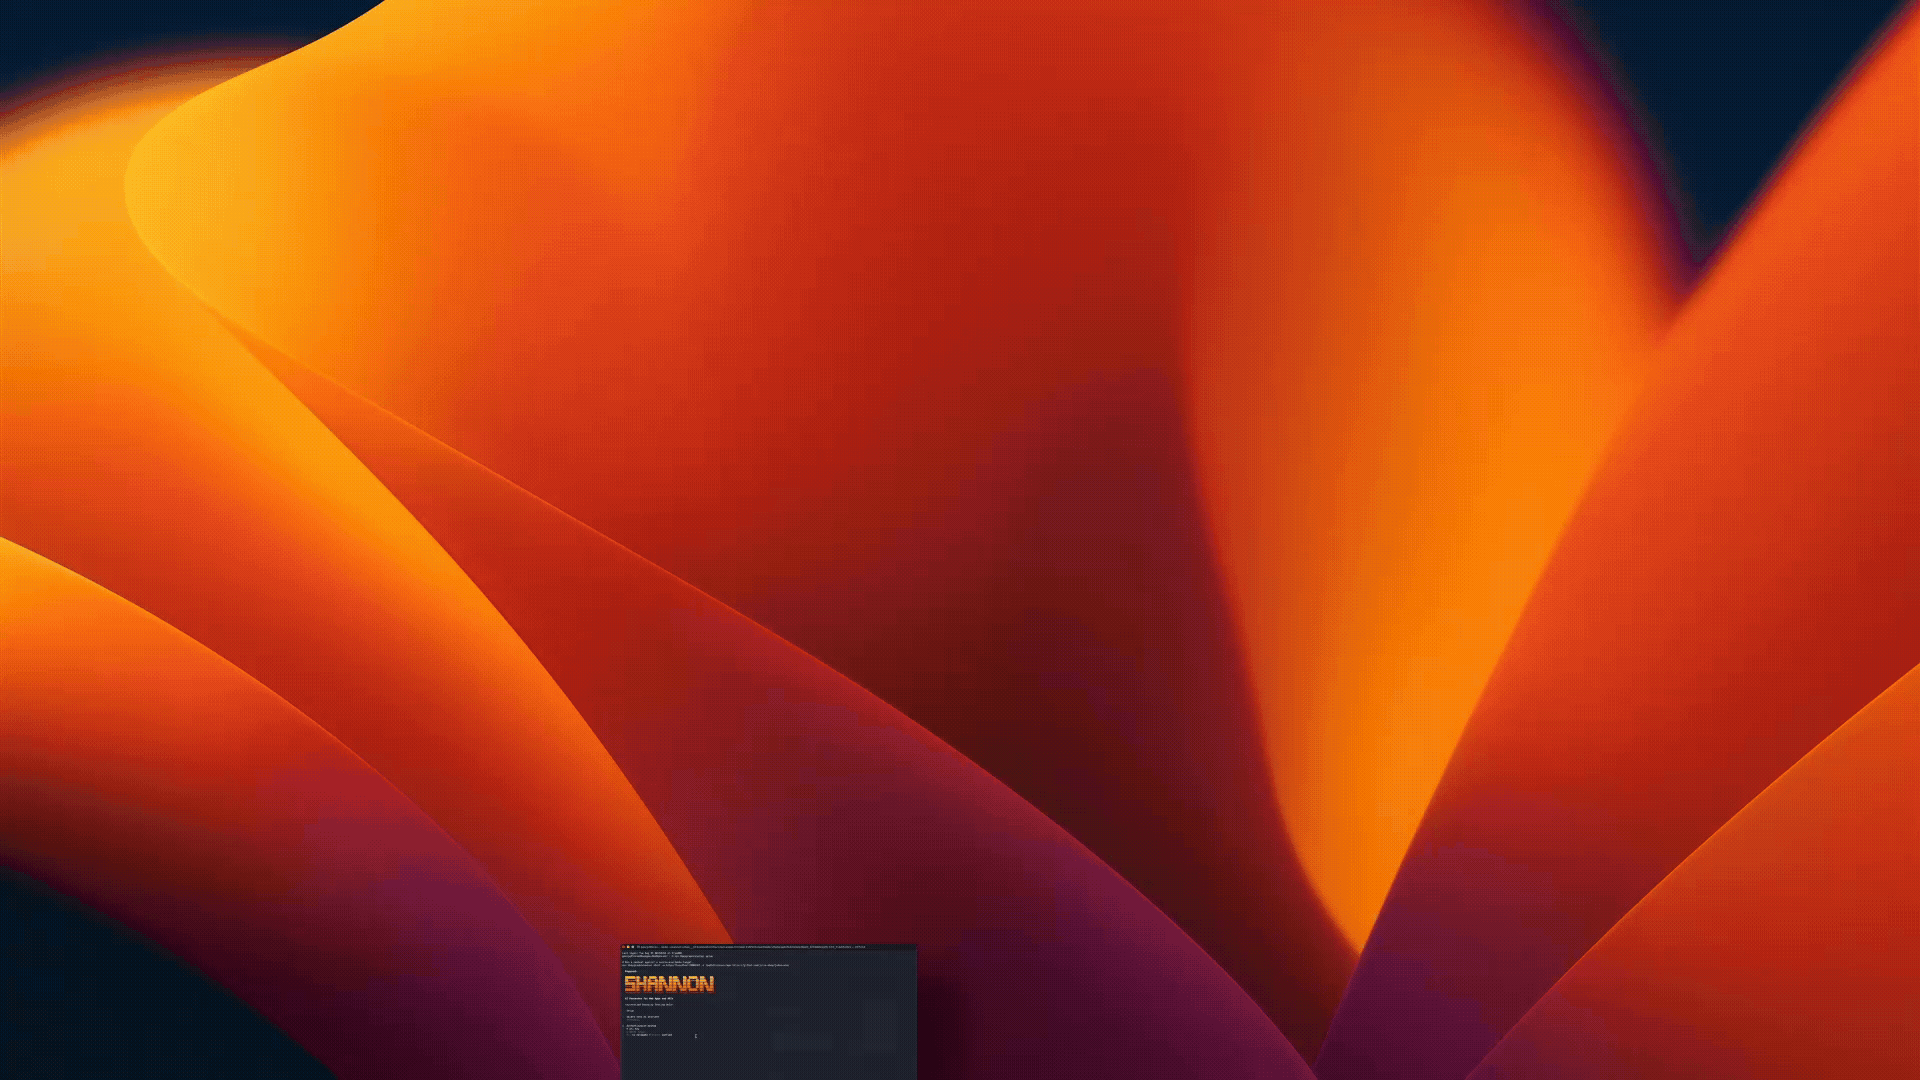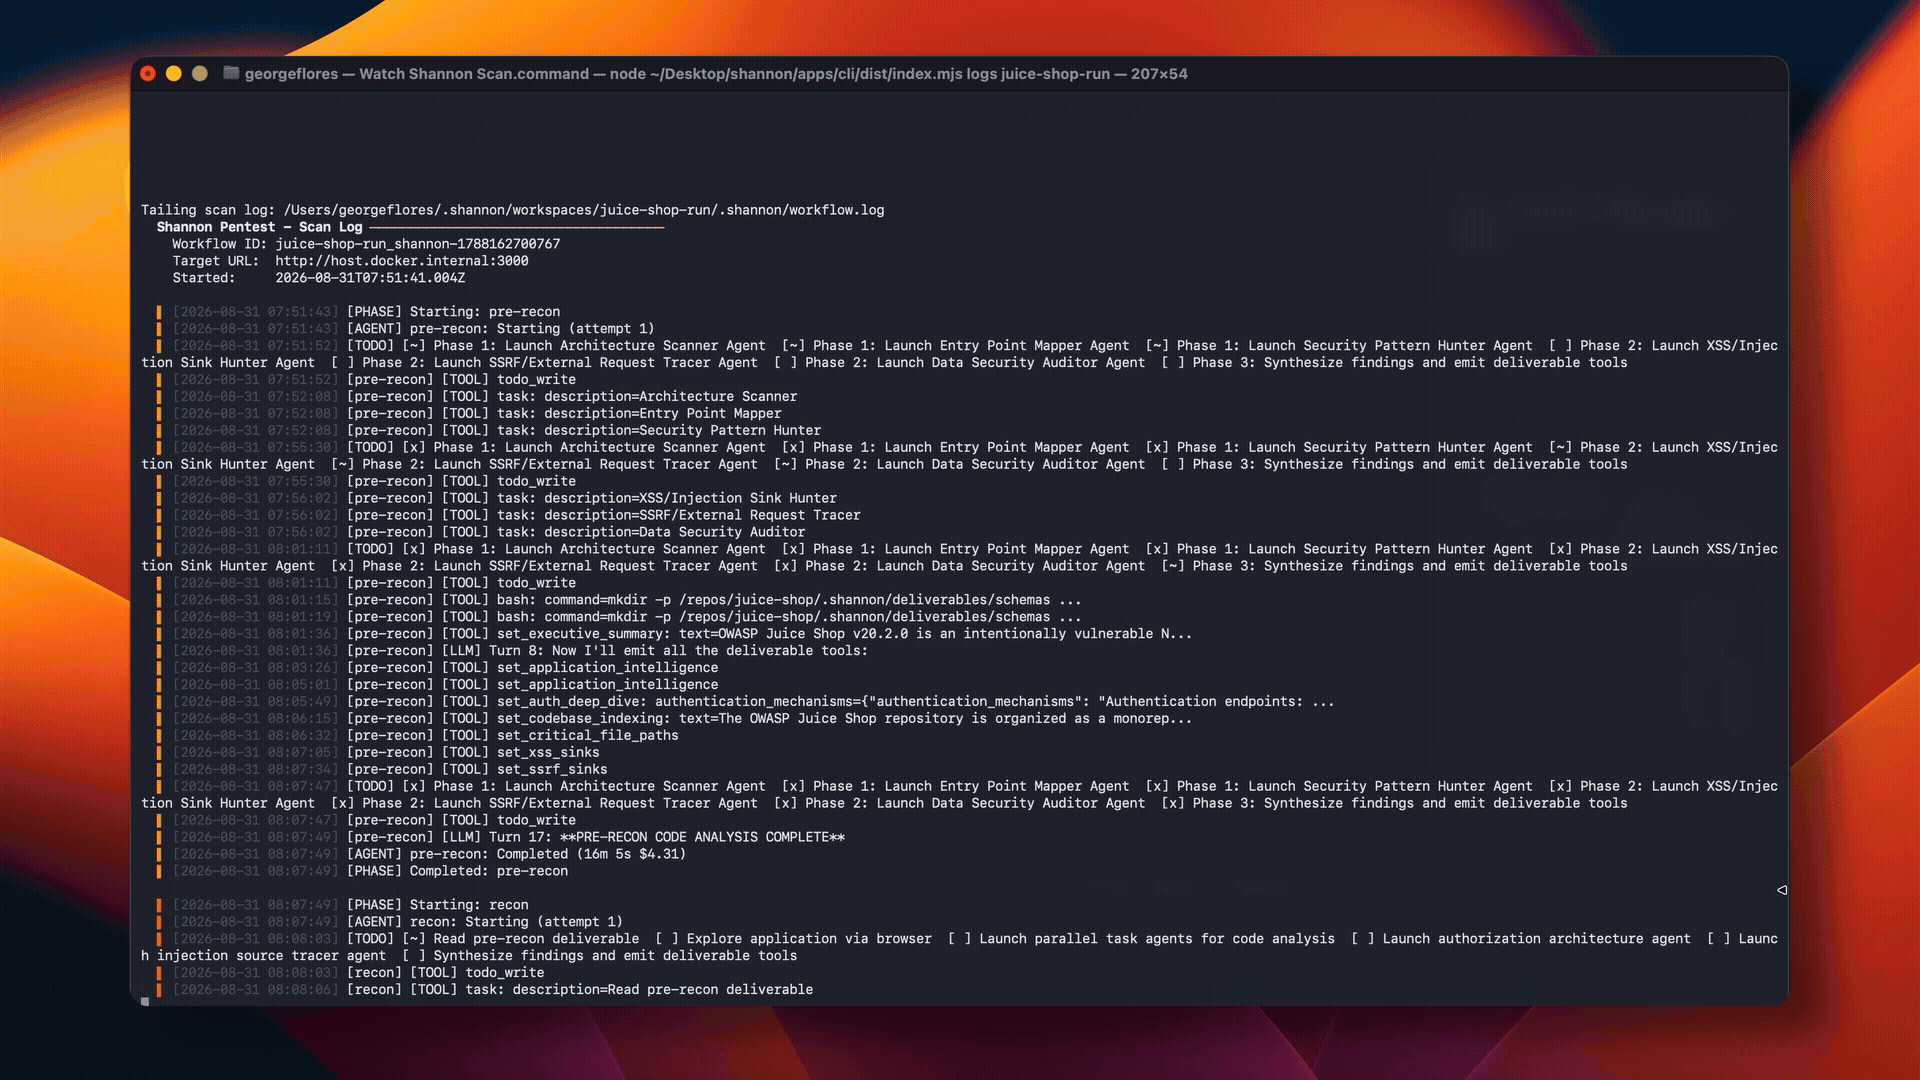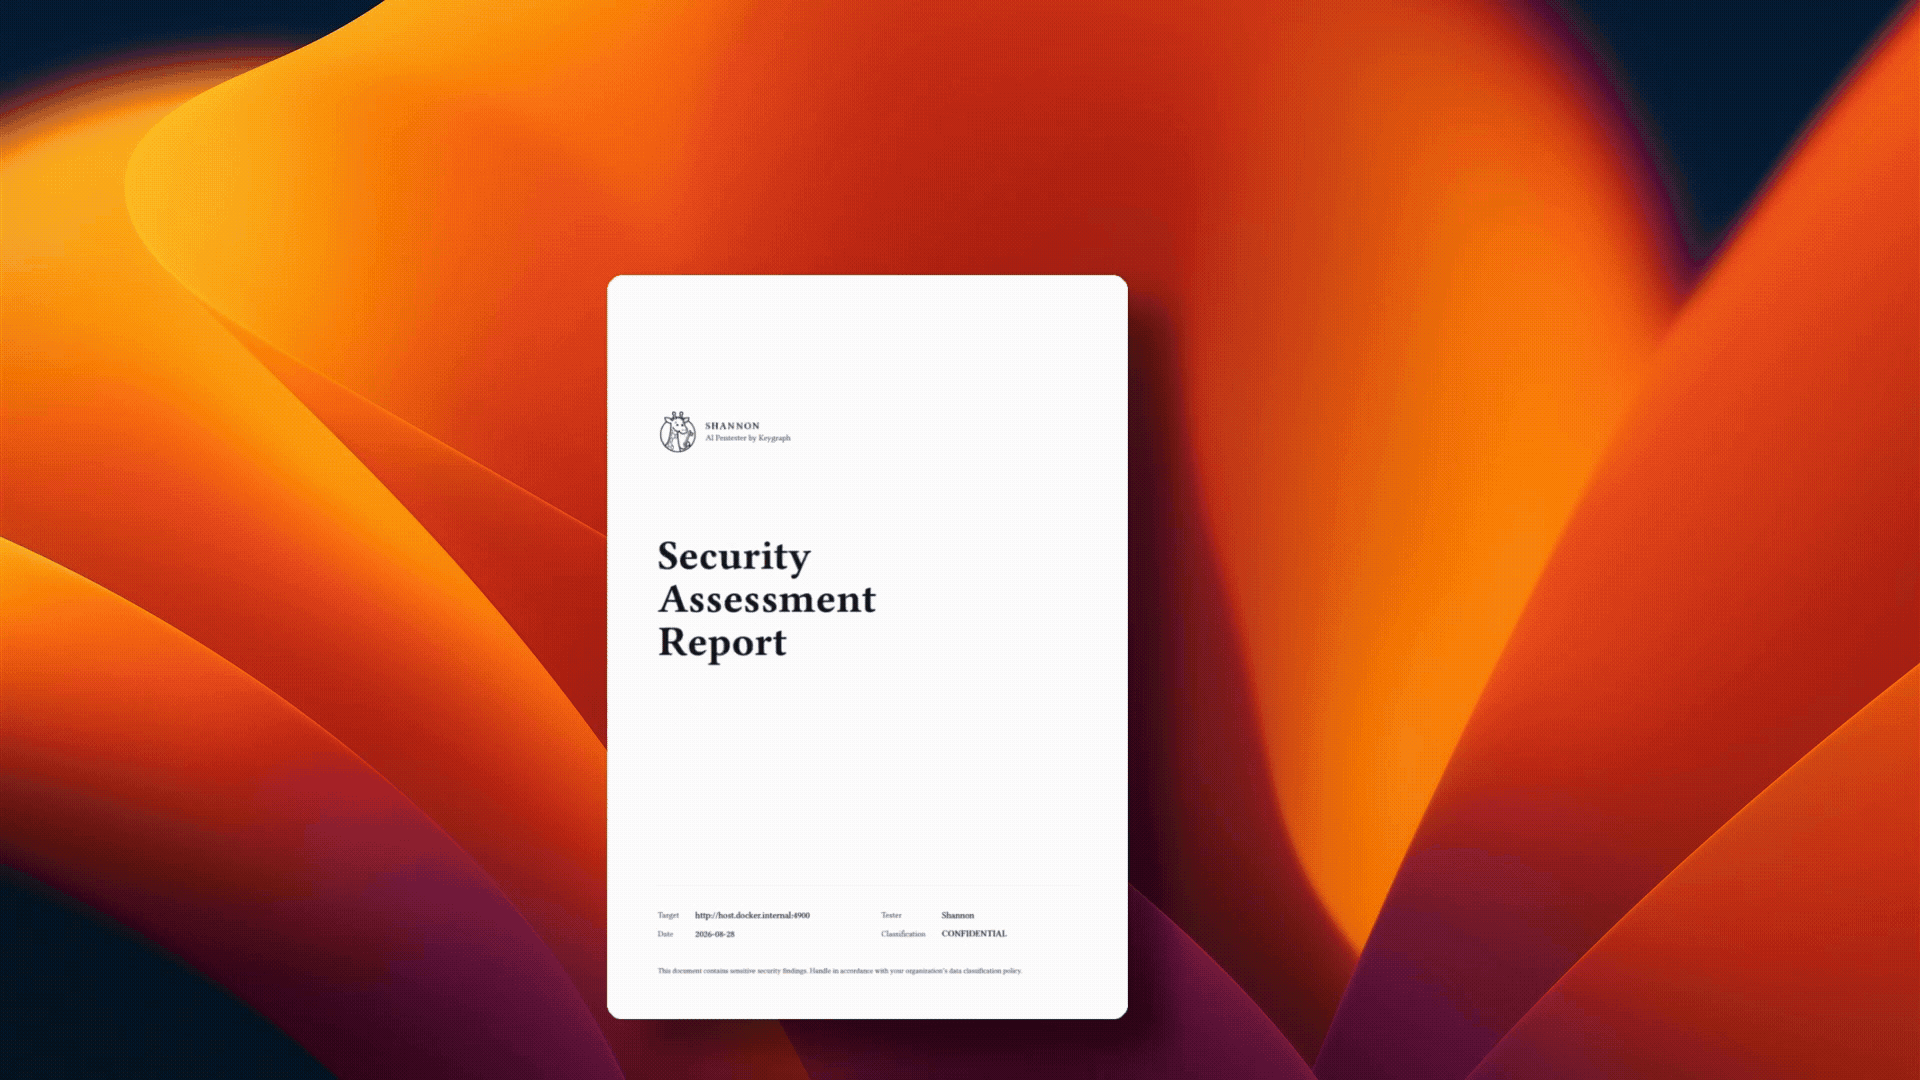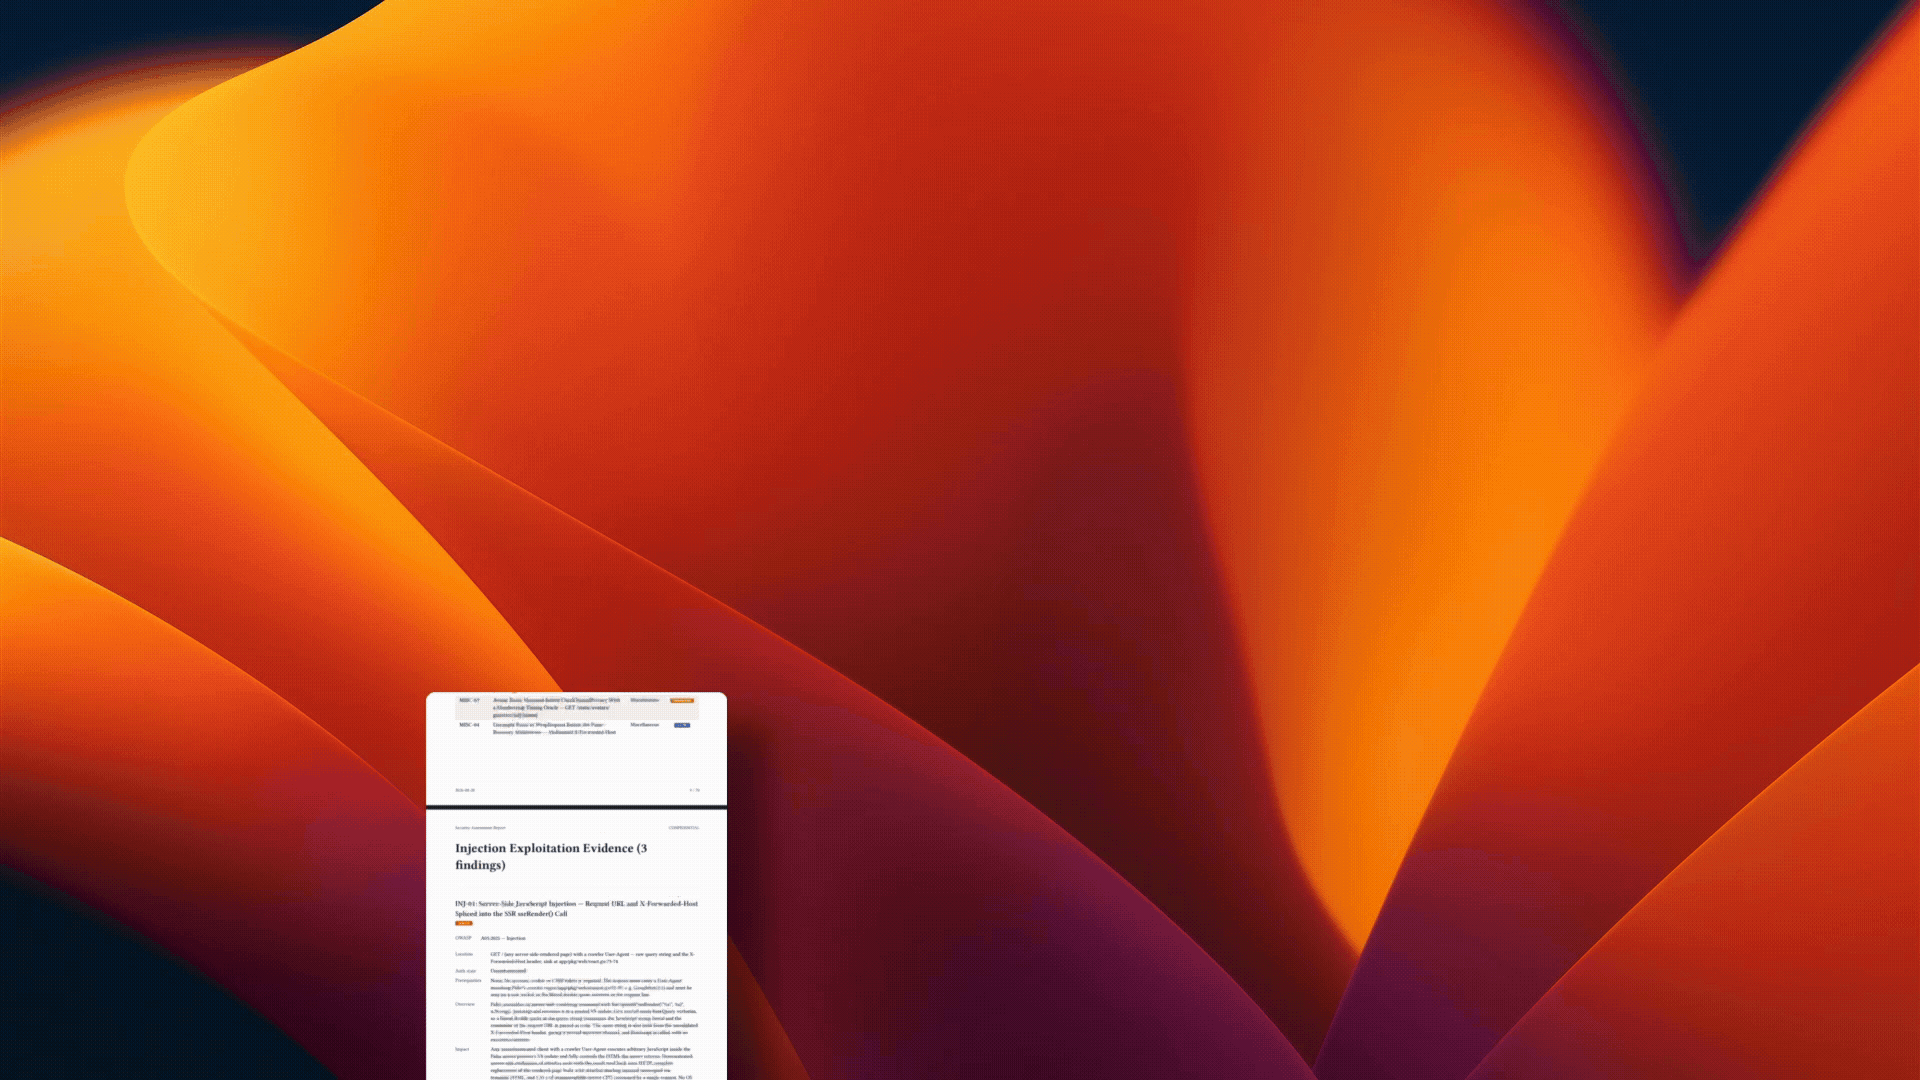
10 月 31 号写过 Shannon,那个是去攻击你跑着的网站。这个不一样,它让你的编码 Agent 读代码找漏洞。Cloudflare 说它是自家漏洞挖掘系统最早的起点,后来长成了覆盖整个公司的流水线,这个仓库是单个代码库能用的版本。
它的看点在流程设计。先摸清架构和输入面,再分派多个互相隔离的 Agent 去找,每个疑似漏洞都交给一个新的 Agent 专门去推翻它,最后再换一批新的 Agent 复核一遍。发现漏洞的那个 Agent 永远不负责确认自己的发现。我觉得这是整套流程里最值得抄的一条。
门槛 README 写得很清楚:模型要支持工具调用和并行子 Agent,要装 Node.js,还要一个断网、限资源的系统级沙箱,没有沙箱它就不去执行目标代码,只把线索标成待验证。另外他们自己测下来,跑一次大约只能找到多跑几次总数的一半,所以建议同一个库多跑几轮。MIT,5.8 万星,这周涨了 8000 多。
6. Usagi-org/ai-goofish-monitor:让 AI 替你蹲闲鱼

最接地气的一个。你用大白话说想要什么,比如某个型号、什么价位、哪个城市、只要包邮,它就开一个监控任务,定时去闲鱼搜。搜到新商品会把详情、卖家信息和图片一起交给支持看图的大模型判断值不值得买,觉得行就推到企业微信、Bark、Telegram 这些地方。
后台是完整的网页界面,任务、账号、日志、结果都能点着管理,Docker 一条命令部署。适合蹲二手相机、显卡、绝版书这类得拼手速的东西。
几件事 README 写明了:要自备一个兼容 OpenAI 接口、能看图的模型 Key;闲鱼登录态要用作者给的 Chrome 扩展导出来贴进去;后台默认账号密码是 admin 和 admin123,一定要改。作者也提醒别请求太频繁,否则可能导致账号被限制,项目只供学习研究。MIT,1.65 万星,最近一次提交是 10 月 10 日,今天又冲上了榜。