这两天 AI 圈最热闹的是 Thinking Machines 发的 Inkling 2 Mini。官方的说法是「小到能在你的笔记本上跑」,研究员带着它上飞机,开着飞行模式,在一台 MacBook Pro 上几分钟做出了一个能玩的飞行模拟器(官方博客)。Hacker News 上这条拿了 1387 分(讨论),X 上的热门话题里,一堆人在转「不用 GPU 集群,也没有 API 账单」(X 热门)。
我看完第一件事是低头看自己电脑的内存。官方写的总内存占用大约 20GB,演示用的是 48GB 内存的 M5 Pro。好吧,热闹是别人的。
不过这事也提醒了我:本地跑模型,卡住大多数人的从来不是「哪个模型最强」,而是「我这台机器到底装得下多大的」。所以今天按这个问题翻了一圈 GitHub,挑了五个思路不一样的项目:先测、再压、借硬盘、借手机,最后是把抽屉里的旧设备也拉进来。先交代一句,这五个我都还没亲手跑过,下面是读 README 之后的判断。
先别急着下载,问问电脑能跑啥
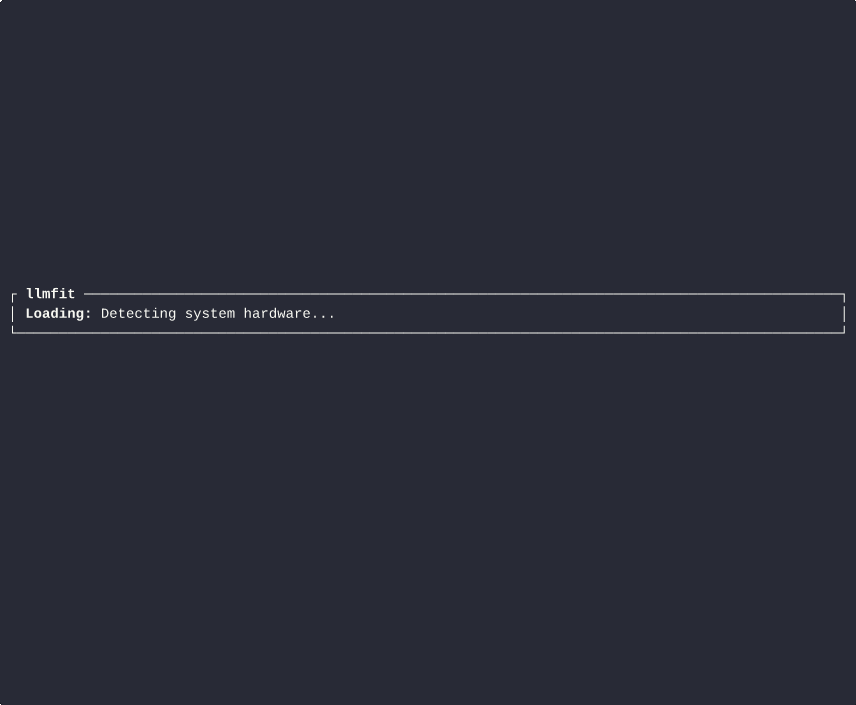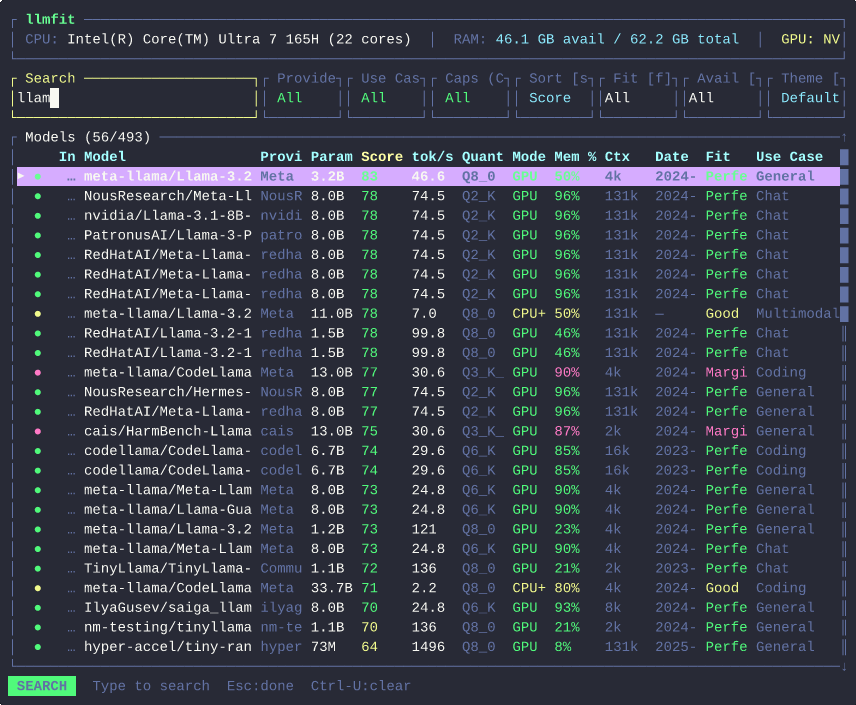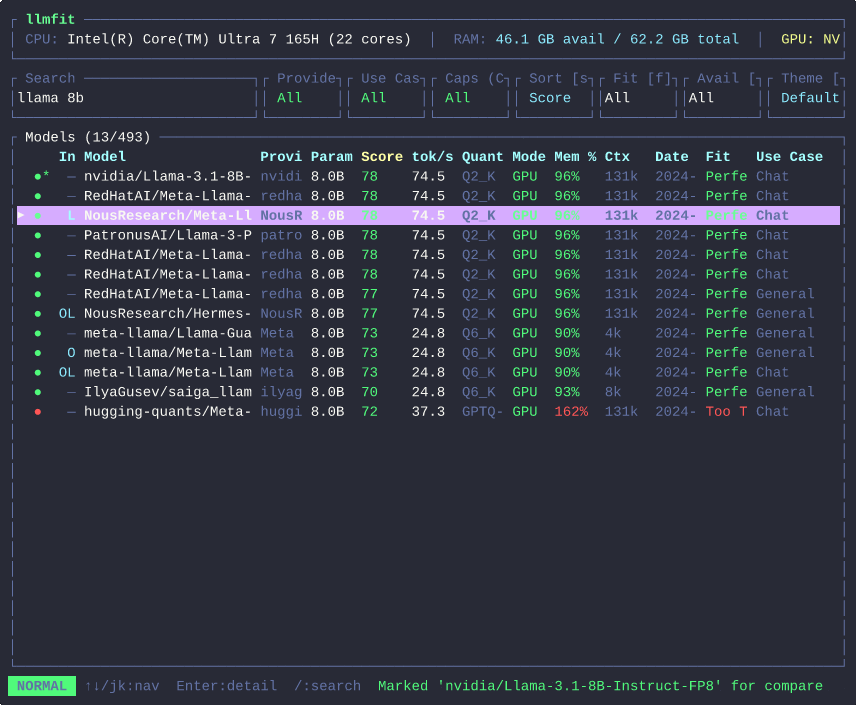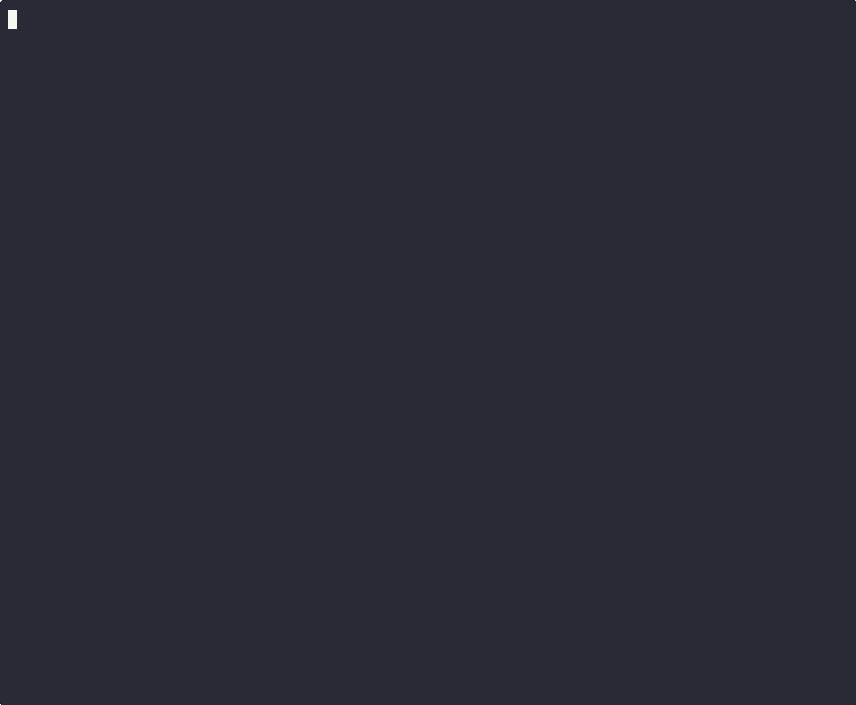
下了二十几 GB 的模型,一跑才发现慢成幻灯片,这种事我干过不止一次。llmfit(39210 星,MIT)就是来拦着你的:它先看你的 CPU、内存、显卡和显存,再把一大串模型按装不装得下、大概多快、质量和上下文长度打分,告诉你哪些在这台机器上真能跑得舒服。
它是今年 2 月就有的老项目,星也多,今天这期我只放它一个老牌的,因为太对题了。最近还在更新,11 月 3 日刚发了 v1.1.20。我最喜欢两个地方:一是可以模拟别的硬件,买新电脑之前先算算多少内存够用;二是速度是估出来的,但它会把估算依据摊开,你也能在自己机器上实测,把结果提交回项目,同款机器的人以后就能看到真实数字。README 还有中文版。
装好 Python 的 uv 之后,一行就能先跑起来:
uvx llmfit
README 自己也说了,它是按配置估算,不是真把模型跑一遍;想直接拉模型实测的,可以看它推荐的 llm-checker。
装不下?把模型压小
今天凌晨 HN 首页还有一条「Inkling-2-Mini 塞进 5.4GB 内存」,拿了 360 分(讨论),说的就是 lookatmyquant(290 星,MIT)。这是一个量化编译器:先挨个测模型里每一块压缩之后对输出伤害多大,再在给定的文件大小里,给每块挑最合适的压法。
作者把 Inkling 2 Mini 18.89GB 的文本权重压出了四个版本。按 README 里他自己测的结果,12.76GB 那版在 GSM8K、HumanEval 和几道看图题上跟原版一题不差;最狠的 5.38GB 版就有代价了,GSM8K 从 96.5% 掉到 88%,HumanEval 从 92.7% 掉到 70.7%。同样的方法还把 Qwen3.8-27B 从 53.7GB 压到 7.2GB。
要说清楚的是,这几个压好的 Inkling 版本是给苹果芯片的 MLX 打包的,Windows 和 N 卡用户暂时只能看看。仓库 10 月 31 日才建,星还少,但思路我挺服:不是一刀切全压成 4 位,而是哪儿重要就多给哪儿几位。
内存不够,拿硬盘来凑
另一条路是不压,直接借硬盘。现在很多大模型是 MoE 结构,每生成一个字只用到一小部分「专家」。InferSSD(1281 星,Apache-2.0)基于 llama.cpp,把暂时用不上的专家留在固态硬盘里,用到再读,用的还是普通的 GGUF 文件,自带网页聊天和 OpenAI 兼容接口。不想碰终端的话,他们还有个基于它的免费桌面版 WiCi Infer。
数字我得老实转述。README 的测试里,48GB 内存的 MacBook Pro 跑 508GB 的 DeepSeek-V4.1-Flash(Q8_0),写字速度每秒 2.874 个 token,比原版 llama.cpp 快了 3.29 倍。快是快了,绝对值还是一秒不到三个字,适合问完去泡杯茶。能跑起来本身就挺离谱了。
一个要留心的地方:README 提醒,开了局域网访问之后接口没有任何认证,谁能连上这个端口谁就能用。仓库 10 月 22 日建,11 月 18 日发了 v0.1.5,更新很勤。
手机别闲着,插上帮忙
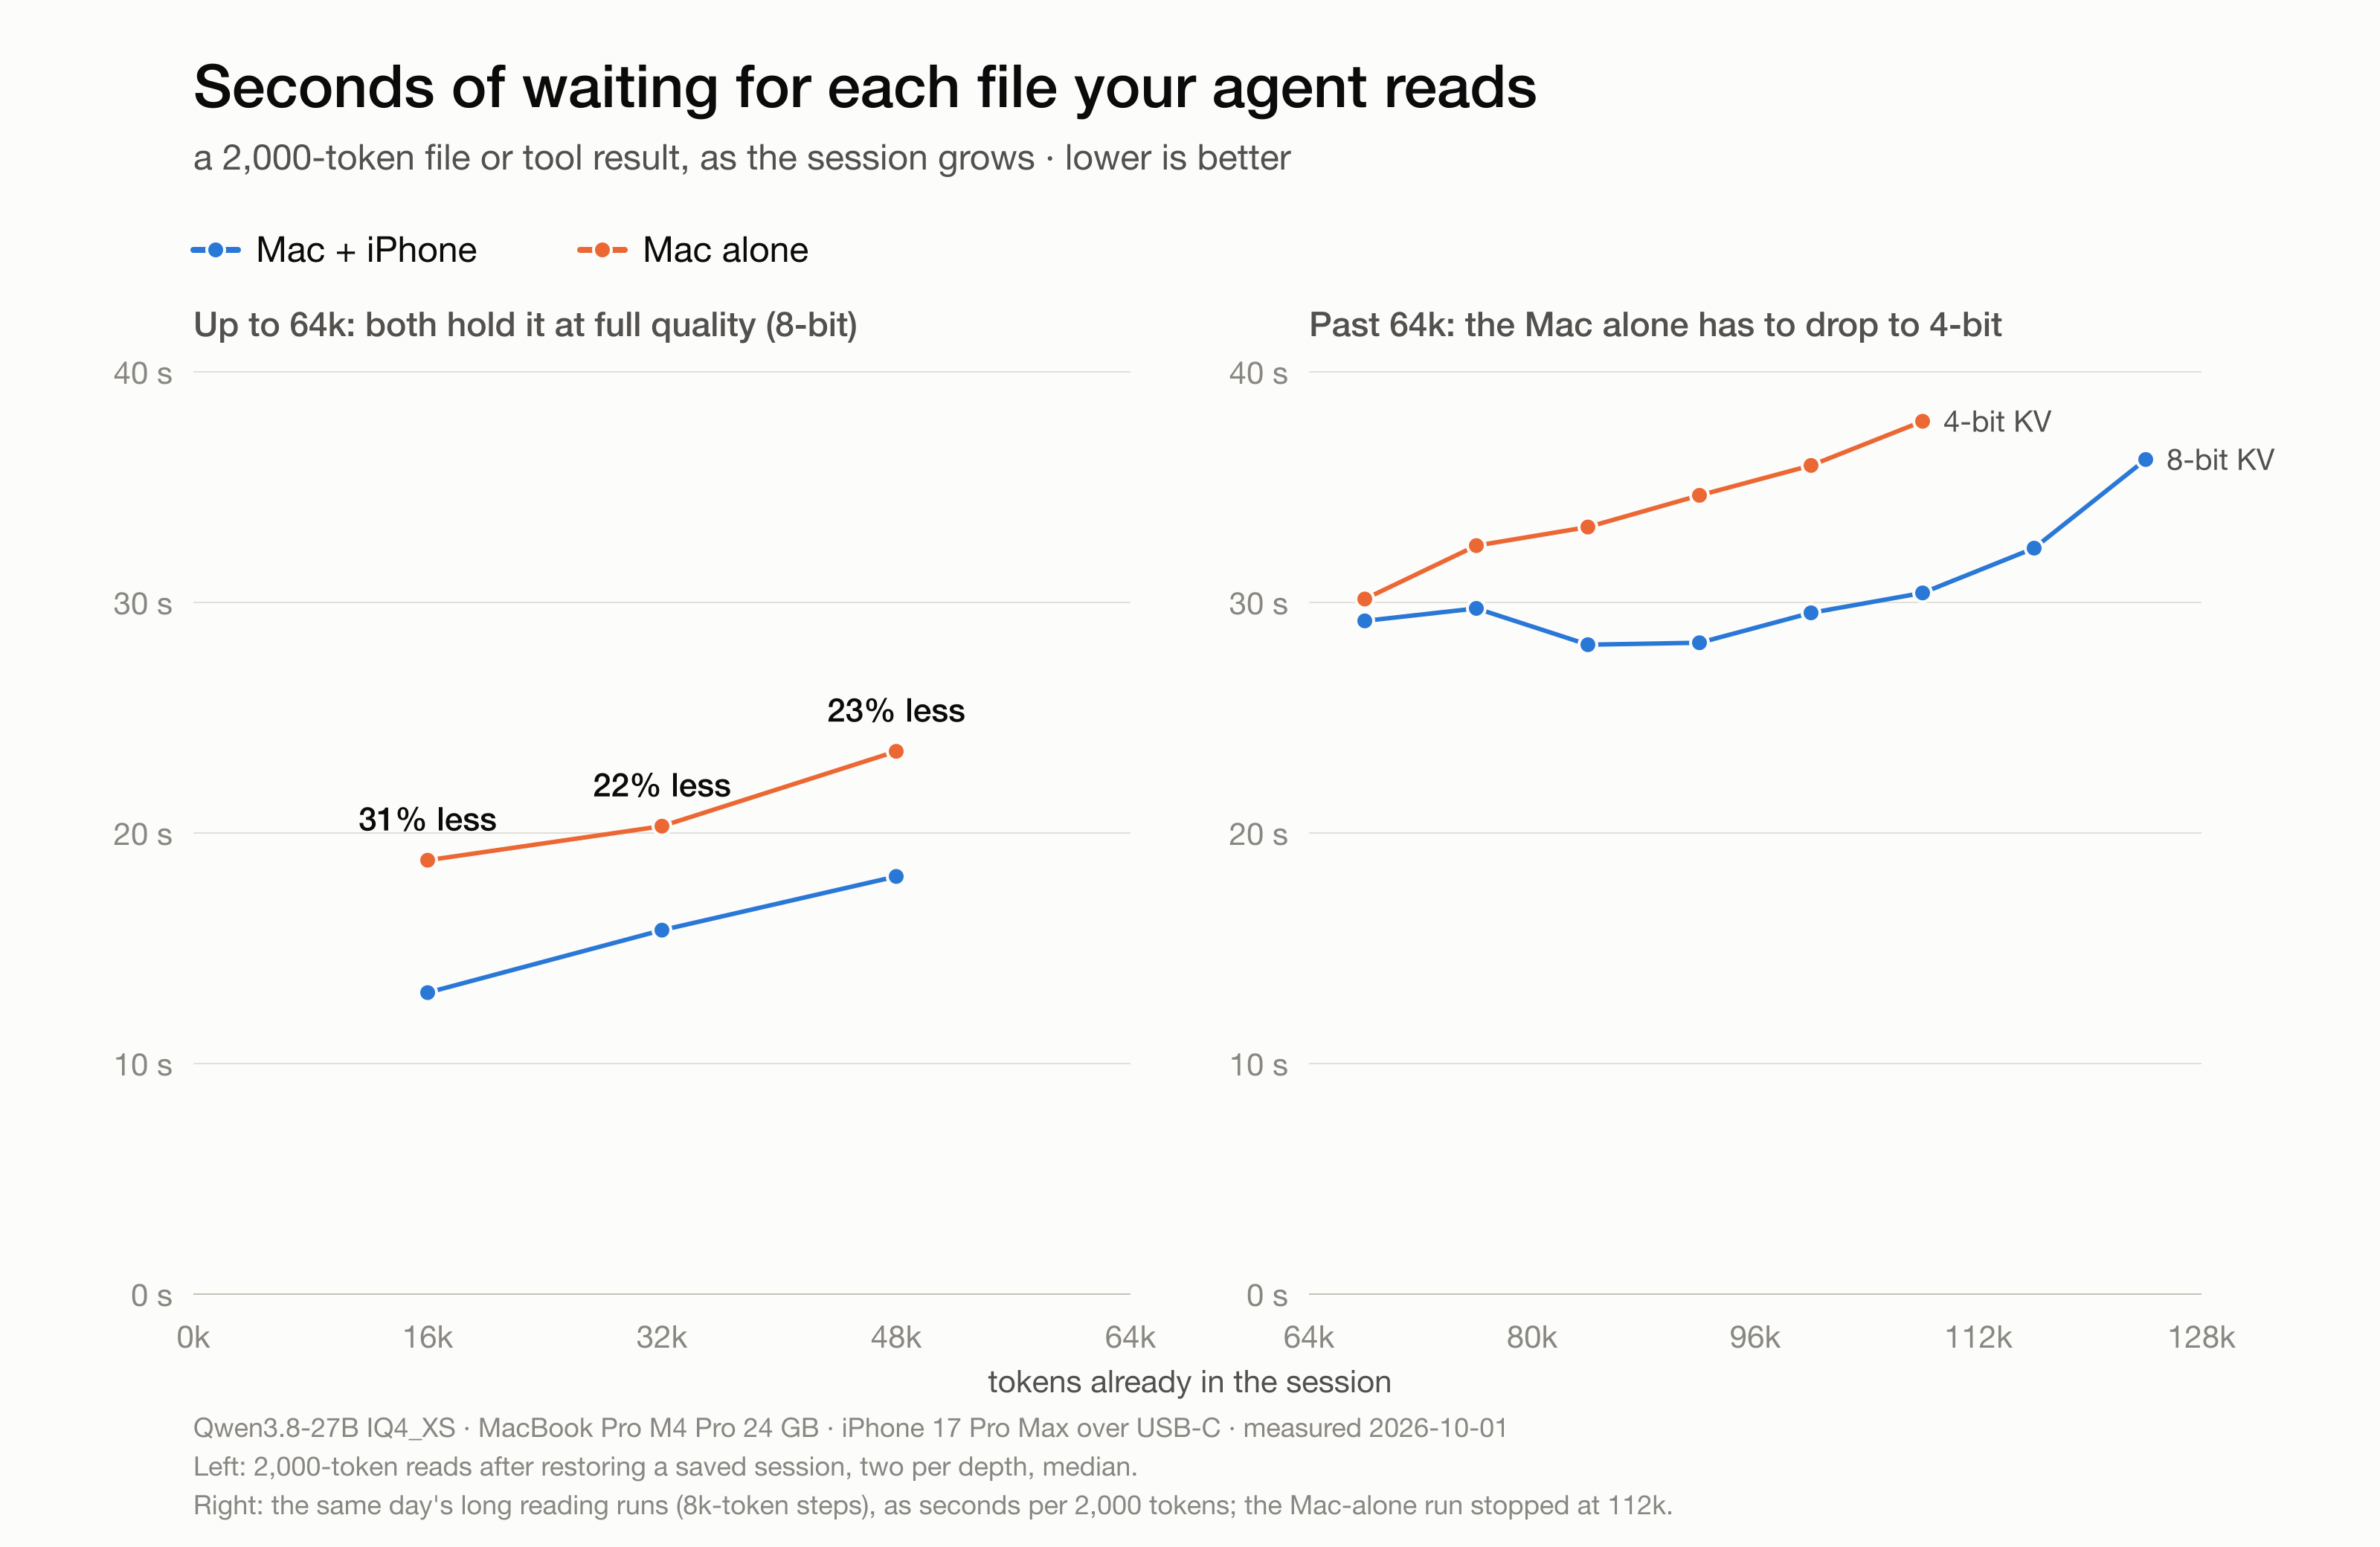
这个是我今天看到最好玩的。Backburner(1196 星,MIT)让你用一根 10Gb/s 的 USB-C 线把 iPhone 插到 MacBook 上,一起跑 Qwen3.8-27B。Mac 跑前 40 层,手机跑后面的层。
作者在 24GB 的 M4 Pro 加 iPhone 17 Pro Max 上测:Agent 读文件、读工具结果这类「读」的环节快了 29% 到 44%;上下文从 Mac 自己装得下的 64k,扩到按手机剩余内存算的 196k 到 229k,实测跑通到 128k。而且开不开手机,输出一个字都不差。
限制写得也很坦白:64k 以内写字速度还是 Mac 自己的,手机不帮忙;超过 64k 时手机上的 App 得一直开在前台,锁屏或拔线服务就停;非 Pro 的 iPhone 是 USB 2 接口,暂时不支持;iPhone 16 Pro Max 长时间读会发烫。10 月 1 日建,最近一次更新在 11 月 7 日。
抽屉里的旧设备,也能跑
最后这个把「本地跑」玩到了头。smolmaxxing(1089 星,MIT)专挑电视盒子、旧手机、旧平板、Kindle 这种平时闲着的设备,看每台最大能跑多大的模型,每个数字都是在设备上实测的。
小米电视盒子 S 第三代,能用的内存大约 1GB,跑 16B 的 Ling-mini-2.0 每秒 5.1 个 token。2022 年的一加 Nord CE 2,空闲内存约 3GB,跑 80B 的 Qwen3-Next-80B-A3B 每秒 2.6 到 3.1 个。最离谱的是 2015 年的 Kindle Paperwhite 3,512MB 内存跑起了聊天机器人;要硬上 4B 模型也行,每秒 0.03 个 token,出一个 token 大概要等半分钟。
用的招数跟上面几个是一个思路:只把常用的专家留在内存,其他的从闪存里现读。代价是门槛不低,电视盒子和 iPad 的模型文件得配作者打过补丁的 llama.cpp,iPad 那台还得越狱。11 月 4 日建的仓库,11 月 12 日在 HN 拿了 486 分(讨论)。仓库里还有一份 171 次实验的记录,失败的也写了,光看这个就挺下饭。
怎么挑
不知道自己电脑能跑多大的,先跑一遍 llmfit。用苹果芯片、想把 Inkling 2 Mini 这种新模型塞进更小内存的,看 lookatmyquant。硬盘大、内存小、又不赶时间,试 InferSSD。手边刚好有台 Pro 款 iPhone 的 Mac 用户,不妨给 Backburner 插根线玩玩。至于 smolmaxxing,我当它是周末的乐子,翻出吃灰的旧手机试试,跑起来了截图发群里。
本地跑 AI 这件事,门槛正在一点点往下掉。以前是「等我换台好电脑」,现在可能是「先看看手上这台能干啥」。