今天榜上最让我想点开的,不是又一个 AI 工具,而是一个跟光盘较劲的项目 Disc Image Studio。它能让普通刻录机在 CD、DVD 甚至蓝光盘的盘面上刻出肉眼看得见的图案。光盘都快成古董了,它一天还涨了 1700 多星。
另外五个:NVIDIA 开源的给 AI 查数据库用的”业务词典”,一个在 8G 内存里硬跑 2.78 万亿参数 Kimi K3 的 C 程序,31 万星的工程师 Skill 合集,一台断网也能用的”知识服务器”,还有一个替你筛新闻的 AI 雷达。前 7 天写过的都跳过了。
1. JiaFeiMiao-K-Cat/DiscImageStudio:把照片刻在光盘的数据面上
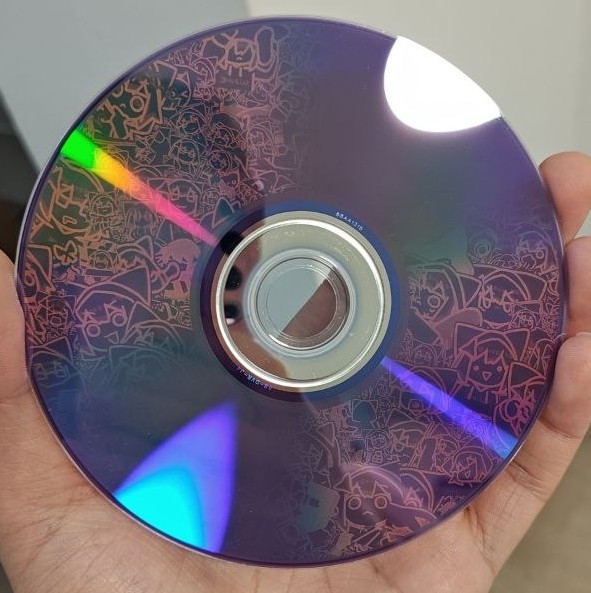
光盘上写数据,烧过的地方和没烧过的地方反光不一样。这个工具反过来用:先决定盘面上哪里该亮、哪里该暗,再倒推出要写进去的数据。刻完之后拿起光盘一看,图案就在上面。
它不挑设备,任何刻录光驱、任何 CD 和 DVD、单层 25G 的蓝光盘都行。CD 导出成音轨文件,DVD 和蓝光导出镜像,用 ImgBurn 这类常见软件去刻就好。还可以在盘的内圈或外圈留一块区域放正常文件,一张盘既是相册也能存东西。
最见功夫的是标定。每个牌子的光盘轨距都不太一样,不校准的话十字线会刻成弯的。它让你给刻好的盘拍张照,分三步估出真实的轨距,README 里放了校准前后的实拍对比,差别很明显。
几个要知道的:完整的图形界面只有 Windows 版,Linux 和 Mac 上是实验性的命令行;边生成边刻录的”即时刻录”也是实验功能,作者提醒只用可以报废的盘,绝对不要用有数据的盘。GPL-3.0,6661 星,今天凌晨还有提交。
2. NVIDIA/auto-ontology:先让 AI 搞懂”营收”指的是哪个数
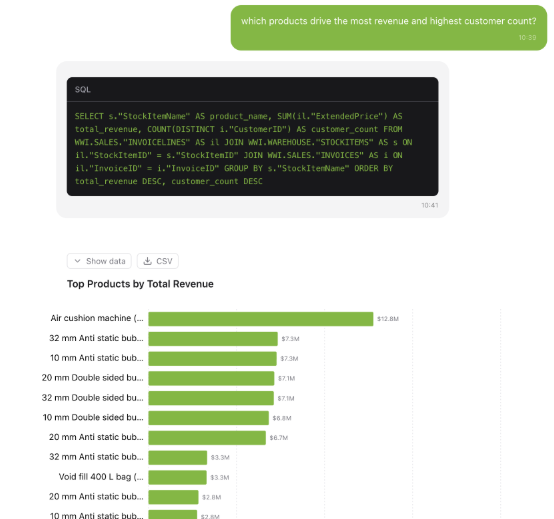
让 AI 直接查公司数据库,最怕的不是慢,是数字错了还说得很自信。同一个”营收”,财务系统和销售系统的口径可能都不一样。NVIDIA 这个库要解决的就是这层:先从你的元数据里自动生成一份业务本体,说清楚数据在哪、什么意思、该怎么用、从哪来,再通过 MCP、命令行和 API 交给任何 Agent 用。
问一句话,它会先找相关的定义,生成 SQL,拿数据库核对过滤条件,查询失败就自己修,最后把答案连同 SQL 和步骤一起给你。通过 MCP 接进来的 Agent 还会先判断这个问题数据能不能答,答不了就请你把问题说清楚。
适合在公司里做数据分析、想上”问数”类 AI 但被口径问题卡住的团队。上手不算轻:要 Docker、一个 NVIDIA 的 API key,README 特别提醒 Compose 会把 Postgres、pgAdmin 和网页端口暴露在本机,启动前要把每个默认密码都换掉。另外它目前不接受外部贡献。Apache-2.0,5201 星,今天一天涨了 2000 多,今天凌晨也还在提交。
3. FareedKhan-dev/kimi-k3-in-c:8G 内存跑 2.78 万亿参数,代价写得清清楚楚
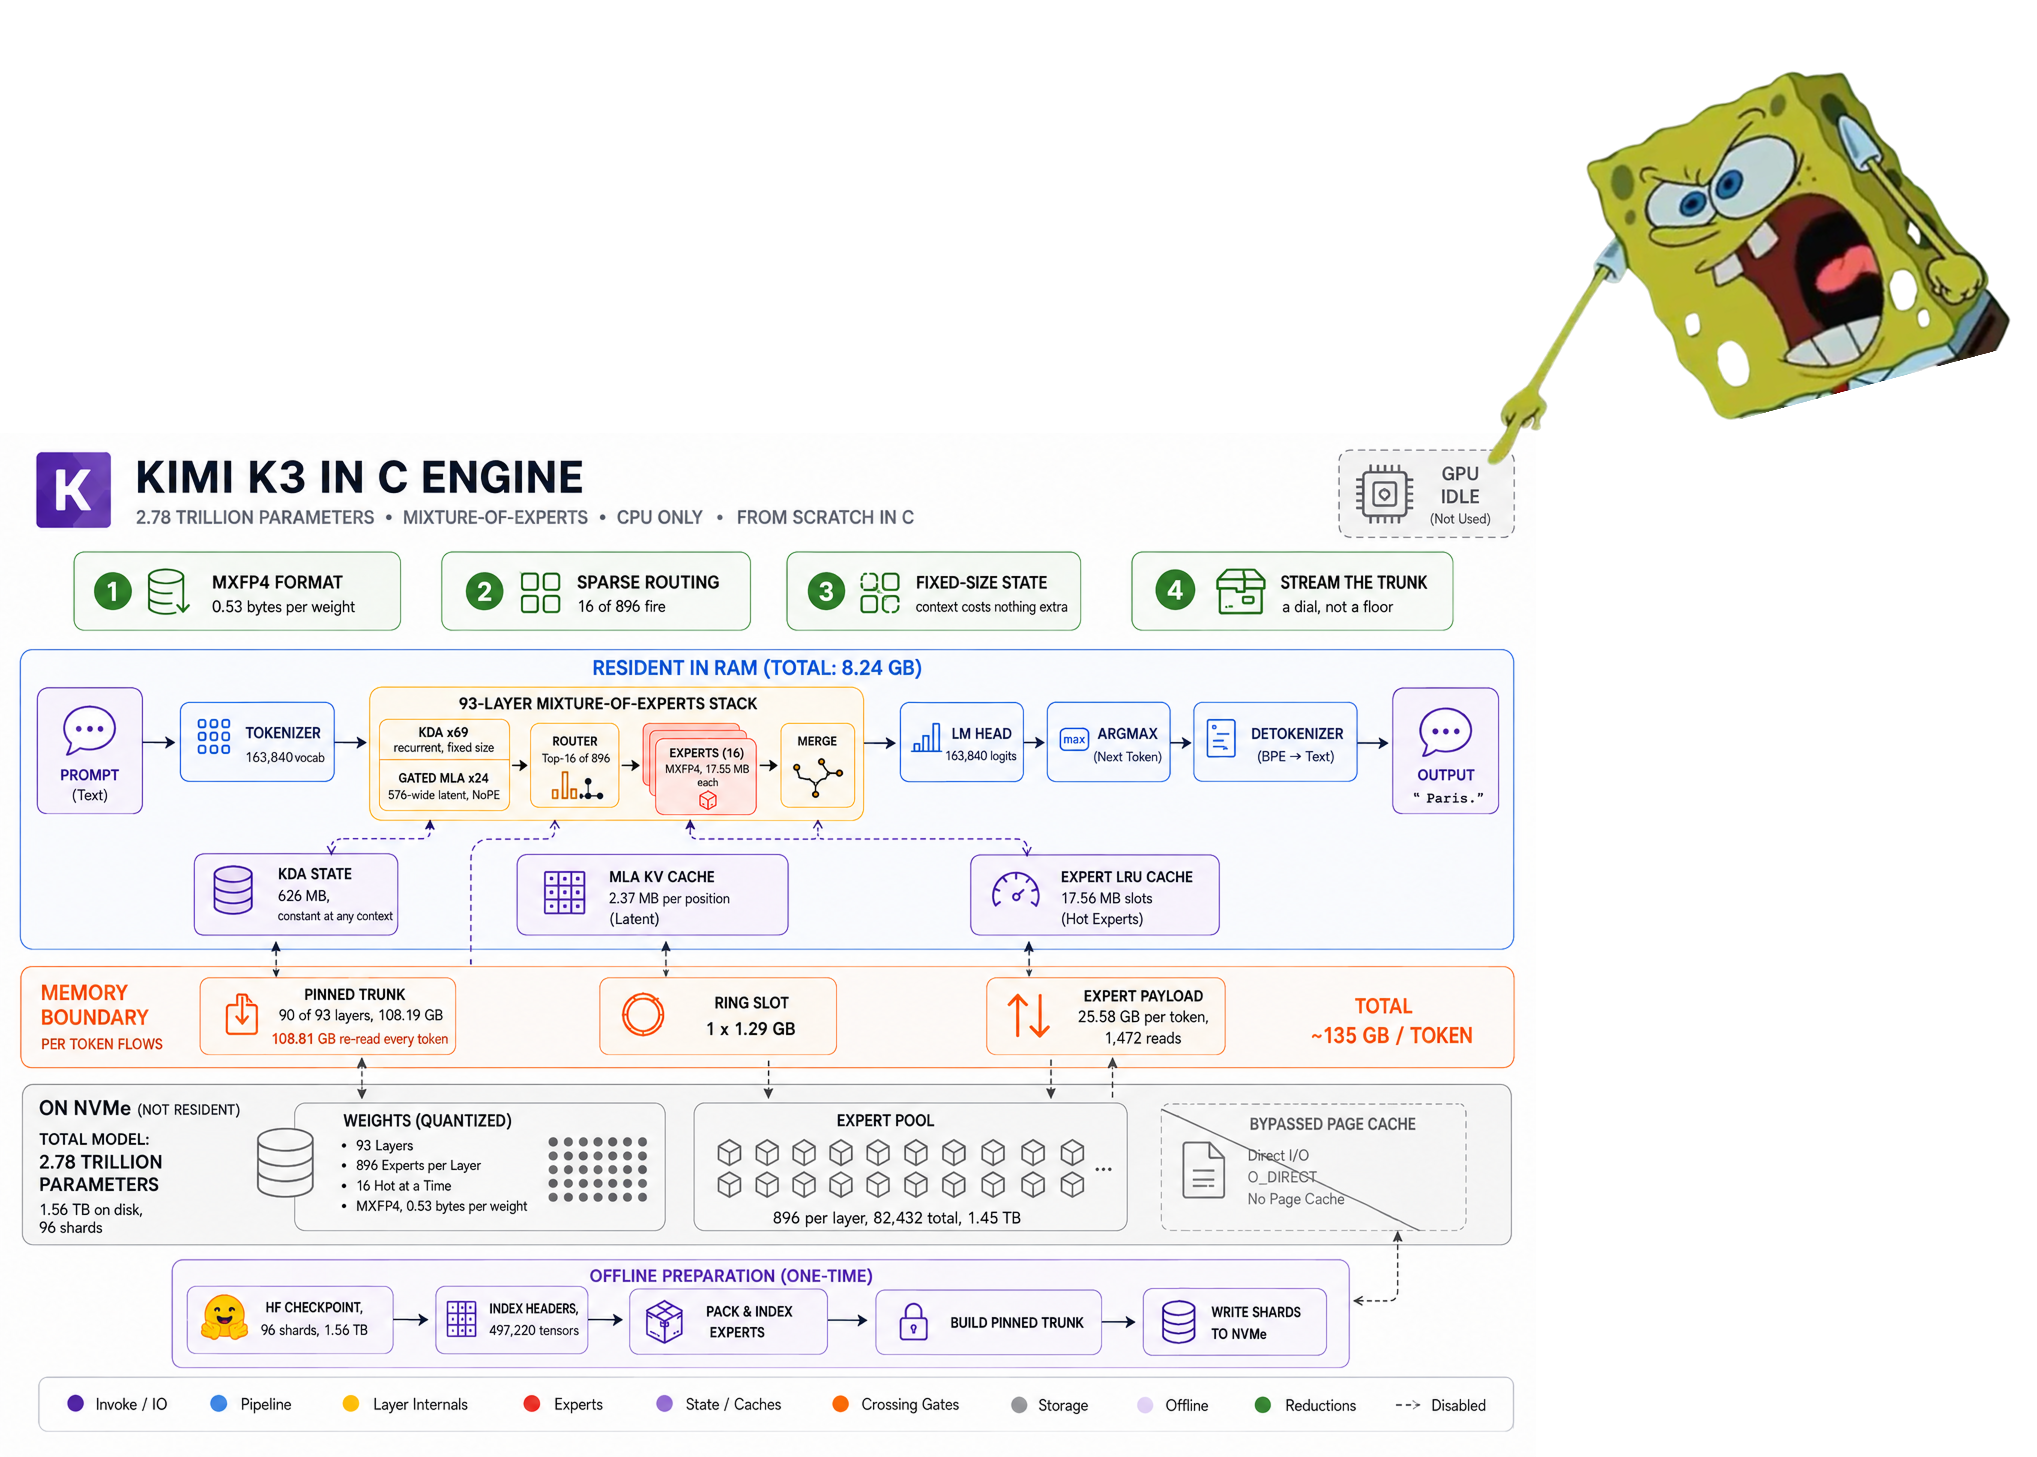
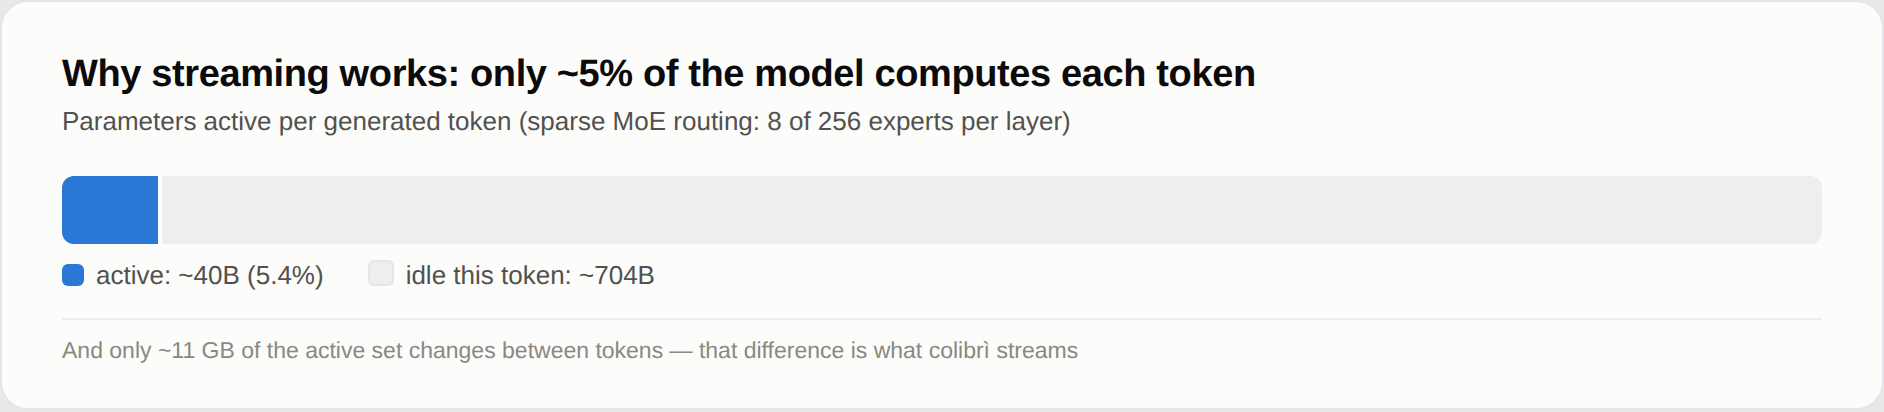
昨天写的 colibri 是 7440 亿参数,这个更夸张:用 C99 写、整个引擎只有 176KB,不用显卡,把 2.78 万亿参数的 Kimi K3 跑在 8G 内存的机器上,实测峰值占用 8.24G。思路差不多,模型绝大部分留在硬盘,每一步按需读进来。
我喜欢它的地方是不藏数字。8G 内存的普通笔记本,一个词要 26.5 秒;128G 以上,整个模型能放进内存,降到 5.6 秒。作者强调,不同内存下输出一字不差,内存多只是换速度。8G 那档他自己也说只是”证明能跑”,不是给你聊天用的。
真正的门槛是硬盘:模型文件 1.56TB,再加 109G 打包文件,要留出大约 1.7TB,最好是快的本地盘,下载以小时计。README 还专门提醒,下载不完整不会报错,只会悄悄输出错字,下载完一定要跑它的校验。适合想研究超大模型怎么”流式”推理的人,不适合想日常用 Kimi 的人。Apache-2.0,10344 星。
4. mattpocock/skills:31 万星的”真工程师” Skill 合集
这是 Matt Pocock 每天给 Claude Code、Codex 用的 Skill,31 万星。他的立场很明确:GSD、Spec-Kit 这类方法把流程全包了,出了 bug 反而不知道该改哪;他的 Skill 都很小,可以拆开组合,用什么模型都行。
我觉得最值得一试的是 grill-with-docs:动手前 AI 先追着你问清楚,同时把项目里的行话整理成一份词汇表。README 举的例子很直观,一大段”把课程里某一节变成真实文件时出了问题”,有了共同词汇后一个词就说完了。其余还有 tdd、code-review、to-tickets、handoff 这些,基本覆盖从想清楚到写完再到交接。
装的话,除了 Claude Code、Codex 各自的插件命令,通用的是这一行:
npx skills@latest add mattpocock/skills
装完要在每个仓库里先跑一次 setup 那个 Skill,告诉它你用哪个 issue 系统、什么标签。README 还提醒,插件和这种复制文件的方式只能二选一,两种都装会得到两份一模一样的 Skill。MIT,昨天还在更新。
5. Crosstalk-Solutions/project-nomad:断网也能查维基、问 AI 的知识服务器
NOMAD 把一堆离线资源打包成一台服务器:离线维基百科和医疗资料、可汗学院的课程、离线地图、加解密工具、笔记,再加一个能读你上传文档的本地 AI 助手。一条脚本装好,之后全在浏览器里用,不用装桌面环境,别的设备用浏览器访问它的地址就行。
它本体很轻,5G 硬盘、1G 内存以内就能跑起来,真正吃空间的是你往里下的内容,吃内存的是 AI 助手。README 直接说了,和那些追求最低配置的”末日电脑”不同,想好好用 AI 就上一台带显卡的机器。只支持 Debian 系系统,推荐 Ubuntu 26.04,Windows 要走社区维护的 WSL2 路线。
适合常跑野外、船上、偏远地区的人,学校、图书馆,或者就是喜欢”万一断网也不慌”的折腾党。Apache-2.0,4.2 万星,今天早上还有提交。
6. Thysrael/Horizon:让 AI 替你从信息流里捞出值得读的
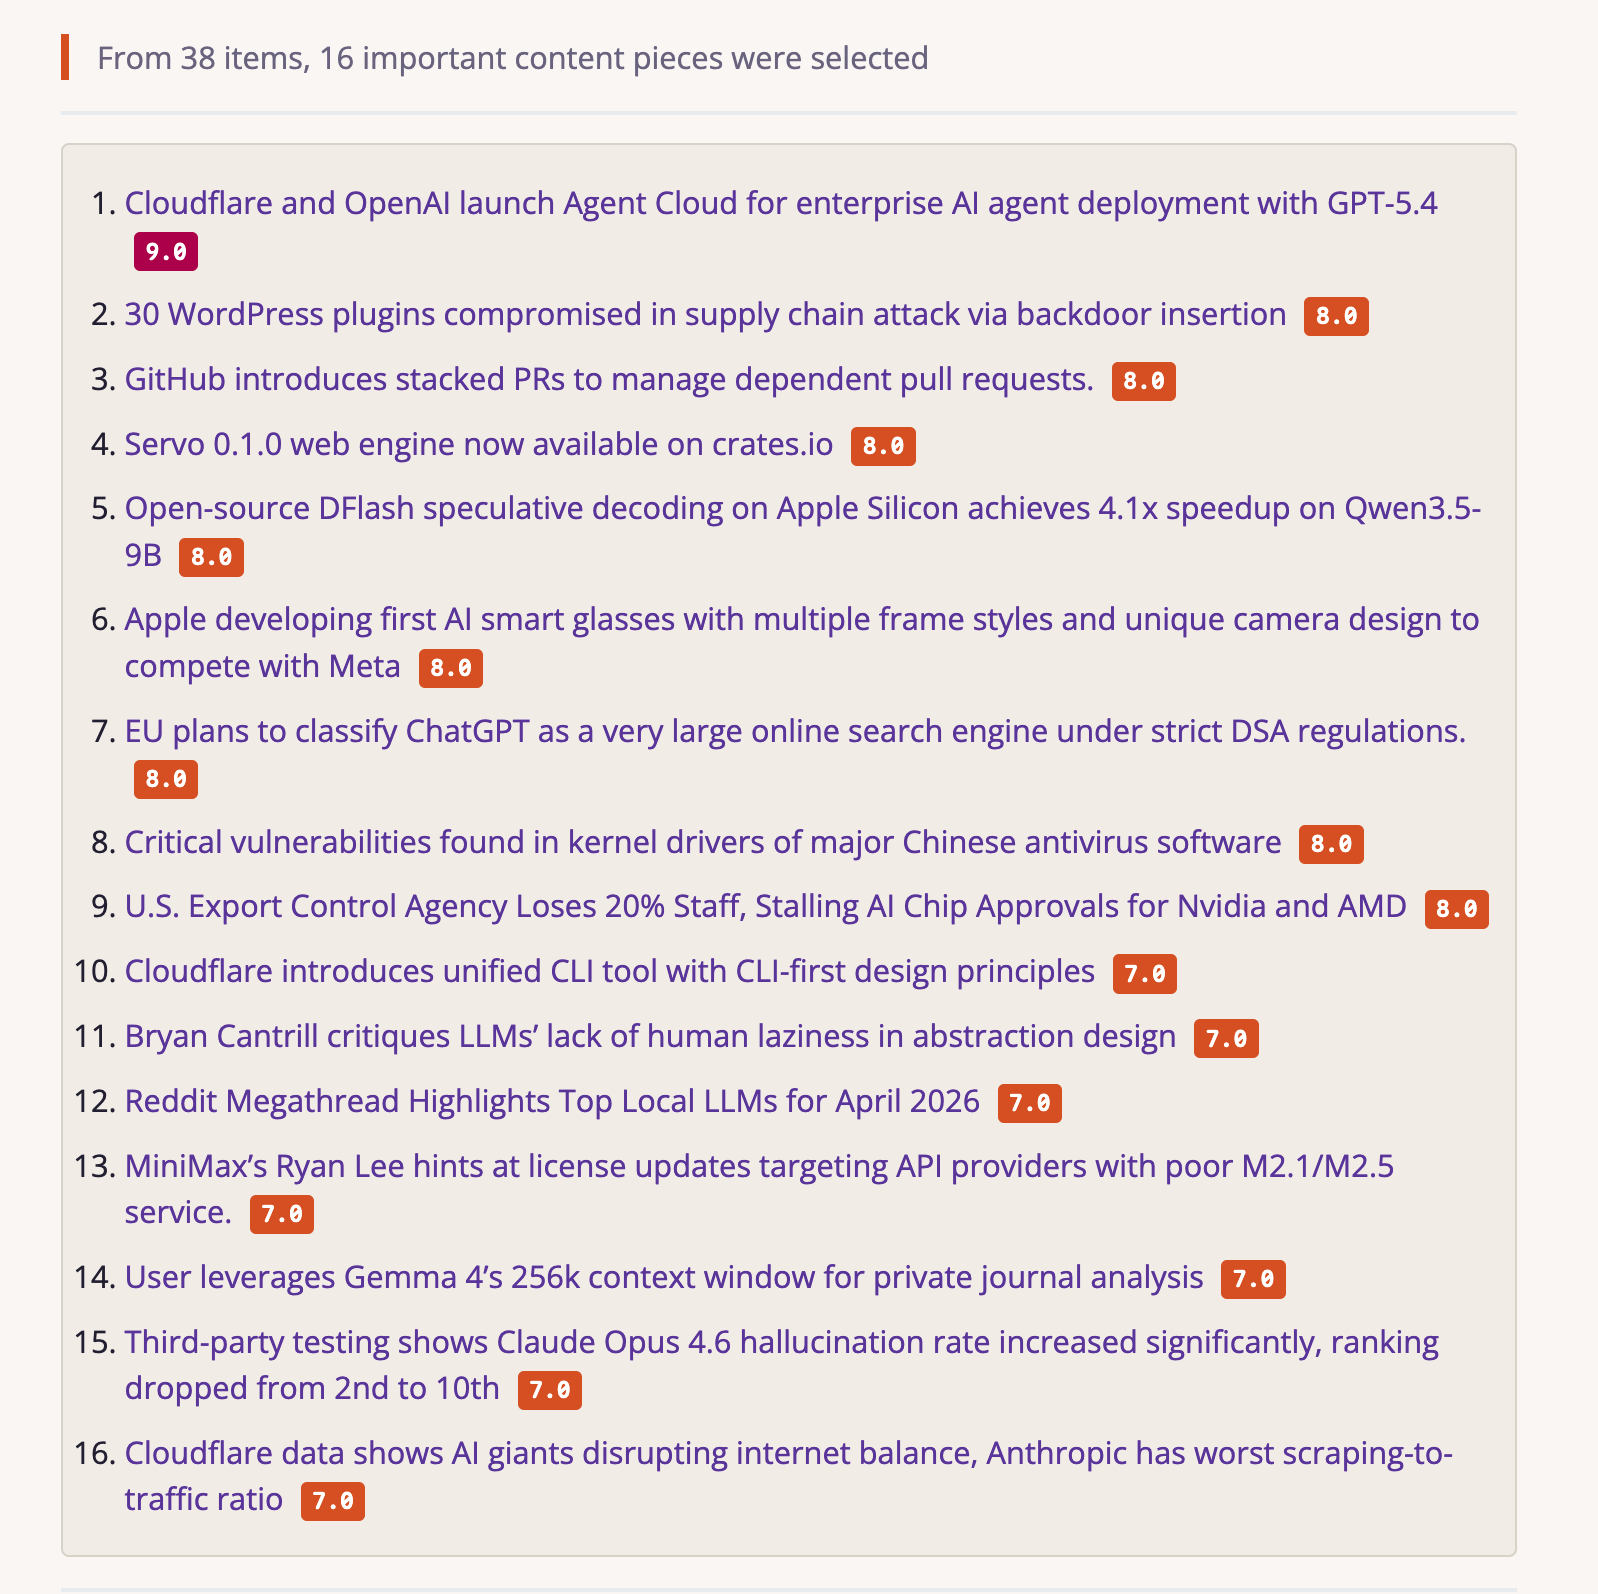
好内容散在 RSS、Hacker News、Reddit、X、GitHub 各处,人的注意力有限。Horizon 把这些源收在一起,用 AI 打分、去重,挑出值得看的,再补上背景和社区讨论,生成中英文简报,能推到飞书、微信、邮件或者网页上。
它有个想法我挺认同:不同内容该用不同读法。新闻要讲”为什么重要”,技术长文要讲”我能拿来用什么”。它用一组可以自己改的规则来区分,自带科技新闻、技术博客、AI 内容创作者三套,改规则一般不用动 Python。
适合每天要追行业动态的人,做内容的也能拿来找选题。第一次配置可以用它的交互向导,问你关心什么然后自动生成配置。要注意,抓 X 需要额外装浏览器组件,现在的 Docker 镜像里没带。MIT,1.25 万星,作者有中文 README 和 QQ 群。